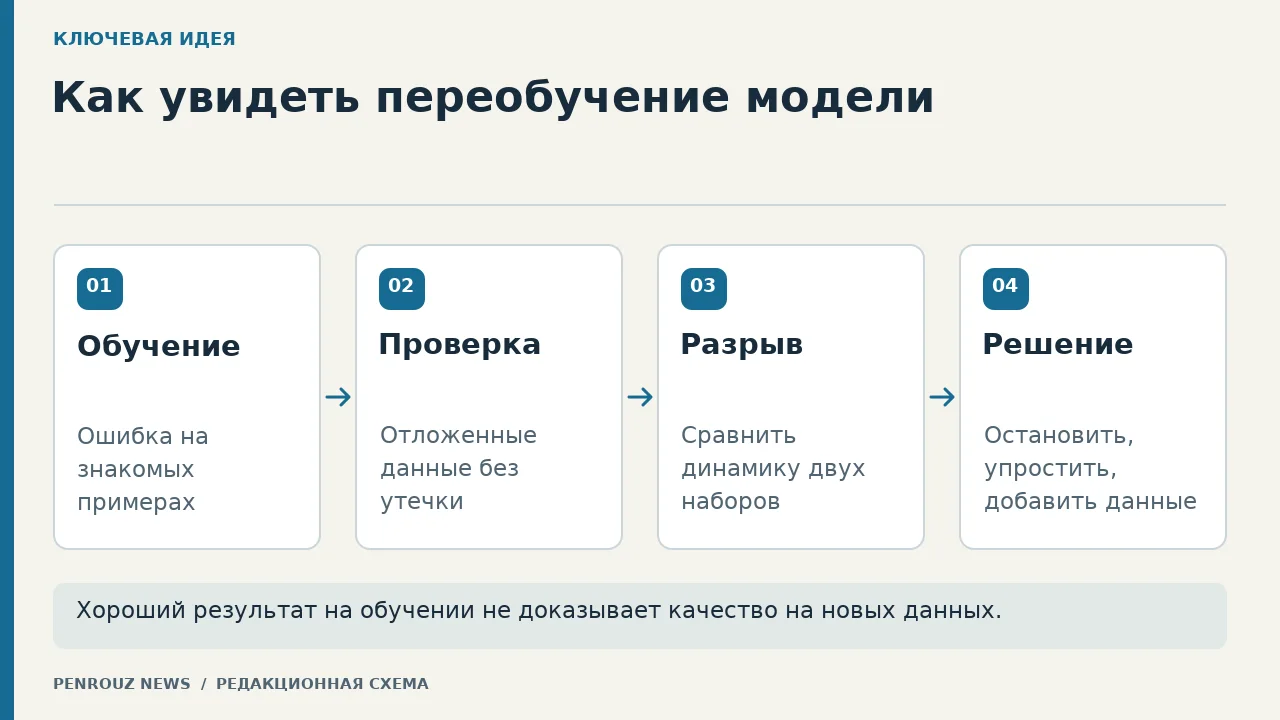
Переобучение нейросети: как распознать и проверить
Переобучение видно не по одному высокому показателю, а по устойчивому разрыву между обучением и проверкой на новых данных. Разбираем отличие от недообучения, корректное разделение выборки и проверяемую последовательность диагностики.
Короткий ответ: переобучение видно на новых данных
Переобучение возникает, когда модель всё лучше справляется со знакомыми обучающими примерами, но не переносит найденные закономерности на новые данные. Главный признак — устойчивый разрыв между качеством на обучающем и отложенном наборах: обучение продолжает улучшаться, а проверка останавливается или ухудшается. Один высокий показатель на обучении ничего не доказывает без независимой проверки.
Недообучение выглядит иначе. При нём модель плохо работает и на обучающих, и на отложенных примерах: она ещё не выучила даже основные закономерности или её возможности слишком ограничены. Хорошо обученная модель находится между этими крайностями: качество на знакомых данных приемлемо, а результат на новых примерах остаётся близким и стабильным.
Сначала полезно увидеть, как устроен простой учебный классификатор, а затем добавить раздельную оценку его обучения и обобщения.
Почему ошибка на обучении может обманывать
Алгоритм оптимизации получает обратную связь именно по обучающему набору. Поэтому снижение ошибки на нём — ожидаемый результат процесса, а не доказательство пригодности модели. Если модель достаточно сложна, она может приспособиться к случайным сочетаниям признаков, редким формулировкам и даже ошибкам разметки. На знакомых примерах это выглядит как успех, но на новых запросах такие детали не повторяются.
Причина не всегда только в архитектуре. Нерепрезентативная выборка, дубликаты, слишком похожие объекты и утечка признаков тоже создают ложное впечатление качества. Поэтому диагноз начинают не с добавления регуляризации, а с проверки границ данных: какие объекты видела модель, какие использовались для выбора настроек и какие действительно оставались закрытыми до финальной оценки.
Обучающий, валидационный и тестовый наборы
Обучающий набор нужен для изменения параметров модели. Валидационный — для наблюдения за обучением, выбора контрольной точки и сравнения вариантов. Тестовый — для финальной проверки уже выбранного решения. Эти роли нельзя смешивать: если постоянно менять модель после просмотра теста, тест постепенно превращается в ещё один валидационный набор и перестаёт быть независимым.
Универсальной доли для каждого набора нет. Размер зависит от объёма данных, разнообразия классов и требуемой точности оценки. Важнее сохранить независимость объектов, одинаковые правила подготовки и соответствие будущим данным. Например, сообщения одного диалога, версии одного документа или соседние кадры одного видео лучше не разбрасывать случайно по разным наборам: так связанная информация может незаметно попасть в проверку.
Для устойчивой проверки удобно заранее подготовить контрольный набор с понятными сценариями, ожидаемыми результатами и правилами обновления.
Как различать состояния модели
Наблюдение
Вероятное состояние
Что проверить сначала
Ошибка высока на обучении и проверке
Недообучение
Достаточность обучения, признаков и возможностей модели
Ошибка обучения падает, проверка сначала улучшается, затем ухудшается
Переобучение
Контрольную точку до расхождения кривых
Обе ошибки приемлемы и меняются согласованно
Рабочее обобщение
Стабильность по классам и новым периодам
Проверка подозрительно лучше ожидаемого
Возможная утечка
Дубликаты, связанные объекты и признаки из будущего
Это диагностические шаблоны, а не универсальные числовые пороги.
Учебный пример: классификатор обращений
Представим вымышленную модель, которая распределяет обращения по трём очередям: доставка, возврат и техническая помощь. Данные разделили до обучения по идентификатору диалога, чтобы реплики одной переписки не оказались одновременно в разных наборах. Валидация остаётся доступной во время разработки, а тест закрыт до выбора окончательной контрольной точки.
На ранней контрольной точке модель ошибается на обучении и валидации примерно одинаково. После дополнительных шагов ошибки на обучении почти исчезают, но на валидации чаще путаются короткие обращения без явного названия темы. Это не реальное измерение и не обещание точности: пример показывает ход рассуждения. Улучшение на знакомых данных сопровождается ухудшением на отложенных — значит, поздняя точка хуже обобщает.
Следующий шаг — не объявлять модель плохой целиком, а локализовать разрыв. Нужно сравнить классы, длину сообщений, редкие формулировки и источники данных. Если ухудшение сосредоточено в одном типе запросов, полезнее расширить и очистить представление этого сценария, чем бесконечно усложнять всю модель. Если разрыв появляется по всем классам, стоит проверить длительность обучения и сложность решения.
Шаблон задания на проверку переобучения
{
  "objective": "Проверить, переносится ли качество на новые обращения",
  "split_policy": "Разделить по идентификатору диалога до подготовки признаков",
  "training_set": "Используется только для изменения параметров",
  "validation_set": "Используется для выбора варианта и контрольной точки",
  "test_set": "Открывается один раз после выбора",
  "metric": "Одна заранее выбранная метрика и разбор ошибок по классам",
  "leakage_checks": [
    "нет дубликатов между наборами",
    "связанные сообщения не разделены",
    "признаки не содержат будущий результат"
  ],
  "checkpoints": "Сохранять метрики обучения и валидации на одинаковых шагах",
  "acceptance": "Выбранная точка сохраняет качество на закрытом тесте"
}
Проверяемая последовательность диагностики
Зафиксируйте единицу разделения данных: объект, пользователь, диалог, документ или временной период.
Удалите дубликаты и связанные объекты между обучением, валидацией и тестом.
Выберите метрику до просмотра результата и добавьте разбор ошибок по важным классам.
Сохраняйте показатели обучения и валидации на одинаковых контрольных точках.
Найдите момент, когда обучение улучшается, а валидация перестаёт улучшаться или ухудшается.
Проверьте, не объясняется ли разрыв утечкой, сменой распределения или ошибками разметки.
Выберите подходящую контрольную точку и только затем откройте тестовый набор.
Запишите версию данных, правила разделения, параметры обучения и итоговый отчёт.
Сравнивать нужно не только итоговые числа, но и динамику. Одна неудачная точка может быть случайным колебанием, особенно на небольшом наборе. Устойчивый расходящийся тренд информативнее: ошибка обучения продолжает снижаться, а ошибка валидации несколько проверок подряд растёт или перестаёт улучшаться. Решение о контрольной точке принимают по заранее оговорённому правилу, а не по наиболее приятному графику.
Для задачи машинного обучения важно сначала определить данные, целевой результат и способ оценки. Общую связь этих элементов объясняет материал про нейросети и машинное обучение.
Что делать, если переобучение подтверждено
Самое простое действие — выбрать более раннюю контрольную точку, если валидация уже показала момент лучшего обобщения. Это не означает механически сокращать обучение во всех проектах: правило должно опираться на динамику конкретной задачи. Важно сохранить одинаковую процедуру оценки, иначе новое сравнение окажется несопоставимым со старым.
Далее можно уменьшить избыточную сложность модели, ограничить число признаков или усилить регуляризацию. Эти меры заставляют решение меньше приспосабливаться к случайным деталям. Но они не исправляют плохое разделение данных. Если валидация содержит дубликаты из обучения, даже сильная регуляризация не превращает такую проверку в независимую.
Полезнее добавить не просто больше объектов, а новые репрезентативные случаи: редкие классы, альтернативные формулировки, разные источники и пограничные примеры. Копии знакомых объектов увеличивают объём, но почти не расширяют покрытие. Перед добавлением стоит проверить разметку: противоречивые метки могут одновременно мешать обучению и создавать шум в оценке.
При дообучении готовой модели логика остаётся той же: отделяют данные, следят за разрывом метрик и сохраняют контрольные точки. Практический процесс подготовки данных и запуска описан отдельно в материале про fine-tuning локальной модели.
Переобучение, утечка и смена данных — не одно и то же
Переобучение описывает разрыв между приспособлением к обучающему набору и качеством на независимых примерах. Утечка означает, что проверка или признаки содержат сведения, которых не должно быть в момент предсказания. Смена распределения возникает, когда будущие данные заметно отличаются от тех, на которых строилась разработка. Симптомы могут быть похожи, но исправления различаются.
Если валидация превосходна, а реальная работа слабая, сначала ищут утечку и несоответствие будущему потоку. Если обучение и валидация расходятся уже внутри корректного эксперимента, вероятнее переобучение. Если обе оценки были согласованы, а качество упало после изменения источника данных, нужно исследовать смену распределения. Название проблемы следует из устройства проверки, а не только из формы графика.
Как оформить итог проверки
Отчёт должен позволять повторить оценку без догадок. В нём фиксируют версии наборов, единицу разделения, дедупликацию, выбранную метрику, историю контрольных точек и причины выбора финального варианта. Отдельно перечисляют известные ограничения: малые классы, редкие сценарии, неполную разметку и возможное отличие будущих данных. Такой документ полезнее одного максимального показателя.
Тестовый результат следует читать вместе с доверительным контекстом: размером и составом набора, разбивкой по классам и примерами ошибок. Нельзя превращать единственную оценку в универсальную гарантию. Даже корректно проверенная модель может столкнуться с новыми типами входа; поэтому после запуска нужны наблюдение за данными и периодическая проверка на свежих, независимо собранных случаях.
Практический итог
Чтобы распознать переобучение, разделите данные до обучения, исключите дубликаты и связанные объекты, наблюдайте обучение и валидацию на одинаковых контрольных точках и не используйте тест для настройки. Переобучение подтверждает не низкая ошибка обучения сама по себе, а устойчивое ухудшение переноса на независимые данные. После диагноза выбирают более раннюю точку, упрощают модель, регулируют обучение или добавляют действительно новые примеры.
Классификатор и JSON-шаблон служат учебной иллюстрацией. Это вымышленные данные, а не результаты теста конкретной модели или обещание точности.