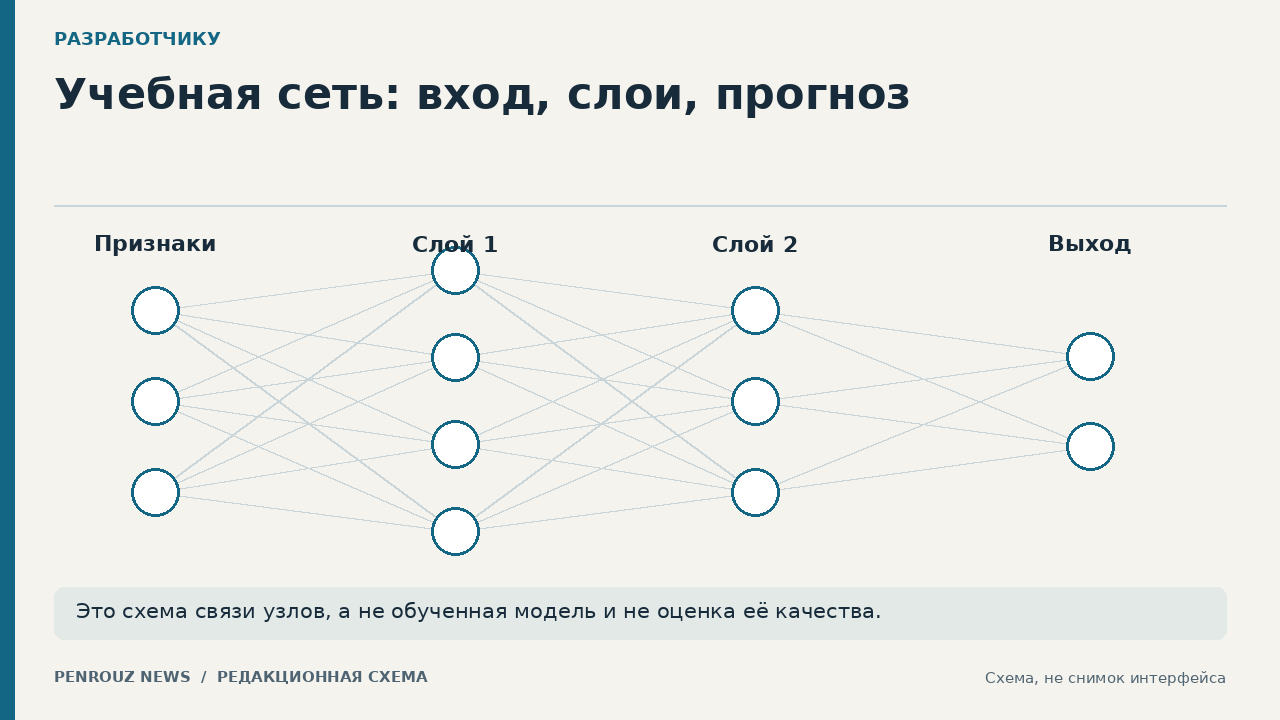
Сделать нейросеть для учебной задачи — не значит обучить собственную большую языковую модель. Практичный первый проект — небольшой классификатор с двумя понятными классами, например отличать вымышленные заявки «доставка» от «возврат». Ценность проекта не в размере сети, а в полном цикле: определить результат, собрать и разметить примеры, отделить тестовые данные, обучить базовую модель, разобрать ошибки и решить, пригодна ли она за пределами учебного набора.
Сначала зафиксируйте вход, классы и правила разметки
Начните с проверяемой формулировки: какой объект поступает на вход, какие варианты ответа допустимы и кто проверяет правильную метку. Для примера вход — короткий текст заявки, выход — доставка или возврат. Запишите исключения: запросы сразу о двух проблемах, пустые сообщения, другой язык. Если правило нельзя объяснить человеку на нескольких примерах, модель тоже будет учиться на непоследовательных метках.
Прежде чем выбирать архитектуру, полезно отделить модель от всей системы: сбор данных, преобразование признаков, обучение, интерфейс и мониторинг — разные компоненты. Их обзор есть в материале «Технологии искусственного интеллекта». Для первого проекта достаточно ноутбука или учебной среды, простого набора данных и воспроизводимого сценария обучения; промышленная инфраструктура не нужна.
Соберите вымышленный набор и начните с малой архитектуры
Создайте вымышленный набор из коротких фраз и меток. Пример класса доставка: «где курьер», «заказ задерживается», «изменить адрес». Пример класса возврат: «товар не подошёл», «как отправить обратно», «когда вернут деньги». Не используйте настоящие обращения клиентов и персональные данные. Удалите дубликаты и спорные примеры или пометьте их для отдельного разбора. Проверьте, что оба класса представлены и что метка определяется смыслом, а не случайным словом.
Затем задайте простое числовое представление текста и маленькую сеть с входным слоем, одним скрытым слоем и выходом для двух классов. Google предлагает интерактивное упражнение, где можно менять число скрытых слоёв, нейронов, скорость обучения и функцию активации, наблюдая тренировочную и тестовую ошибку. Это учебный способ увидеть влияние гиперпараметров, а не универсальная конфигурация для любого набора.
Отделите обучение, настройку и финальный тест
До обучения разделите данные на обучающую, валидационную и тестовую части. Обучающая часть изменяет веса, валидационная помогает выбирать параметры, а тестовая используется для финальной проверки. Google подчёркивает, что модель нужно проверять на других примерах, а дубликаты между обучением и тестом делают оценку нечестной. Не смотрите на тест после каждой правки: тогда решения начинают подстраиваться и под него.
Все преобразования должны быть одинаковыми для трёх частей: нормализация, токенизация, словарь и обработка пропусков. Но параметры преобразования, которые вычисляются из данных, получают только по обучающей части. Зафиксируйте случайное зерно, версии библиотек и точное разбиение, чтобы повторный запуск был сопоставим. Если данных мало, не скрывайте неопределённость за процентом точности.
Смотрите не только на общую точность, но и на типы ошибок
Одной accuracy недостаточно. Для каждого класса посмотрите, сколько примеров модель пропустила и сколько чужих примеров ошибочно отнесла к нему. Составьте матрицу ошибок и прочитайте сами спорные тексты. Если класс редкий, высокая общая точность может сочетаться с полным провалом по нему. NIST связывает точность с реалистичным тестовым набором, методикой проверки и раздельной оценкой сегментов, а надёжность — с постоянным тестированием и мониторингом.
Отдельно проверьте факты в выводах и не принимайте красивый график как доказательство. Общий порядок критической проверки дан в материале «Как проверять ответы ИИ». Для учебного классификатора приготовьте новые фразы, которых нет в датасете, включая опечатки, короткие сообщения и сочетание двух намерений. Низкую уверенность или конфликт классов лучше отправлять человеку.
Малый датасет годится для эксперимента, но не доказывает рабочее качество
Небольшого набора может хватить, чтобы понять механику и обнаружить очевидные ошибки, но нельзя обещать рабочее качество на реальных данных. Качество и представительность примеров часто важнее усложнения архитектуры. Документация Google по обобщению подчёркивает роль качества данных, ненадёжных меток и переобучения. Если задача реальная, соберите примеры именно из будущих условий применения, законно и с контролем доступа.
Сначала сравните сеть с простой базовой линией: правилом по ключевым словам или логистической регрессией. Если сложная модель не превосходит понятный базовый вариант на отложенных данных, усложнение не оправдано. Для малого проекта также разумно использовать готовое представление или предварительно обученную модель, но это уже перенос обучения, а не создание всей модели с нуля.
Чем этот проект отличается от обучения локальной языковой модели
Классификатор с двумя метками решает одну узкую задачу и может быть маленьким. Адаптация готовой локальной LLM меняет поведение большой уже обученной модели и требует другого набора данных, ресурсов и оценки. Этот отдельный процесс разобран в материале «Обучение локальной нейросети». Не называйте обычный промпт или загрузку документов «обучением»: веса модели при этом могут вообще не меняться.
Следующий шаг — воспроизводимые эксперименты и усложнение по необходимости
После воспроизводимого классификатора изучите признаки, переобучение, метрики, дисбаланс классов и только затем переходите к более сложным сетям. Последовательный маршрут с проверяемыми проектами собран в материале «Обучение искусственному интеллекту с нуля». Сохраняйте карточку эксперимента: цель, происхождение данных, правила разметки, разбиение, метрики, типичные ошибки и границы применения.
Проект можно считать завершённым как учебный, если другой человек способен повторить подготовку данных и обучение, получить сопоставимые метрики и увидеть те же ограничения. Это не делает модель готовой к решениям о людях, деньгах, здоровье или правах. Для высоких рисков нужны специалисты, нормативные требования, независимая оценка и мониторинг после внедрения.