Контрольный набор для оценки ИИ: как собрать golden set
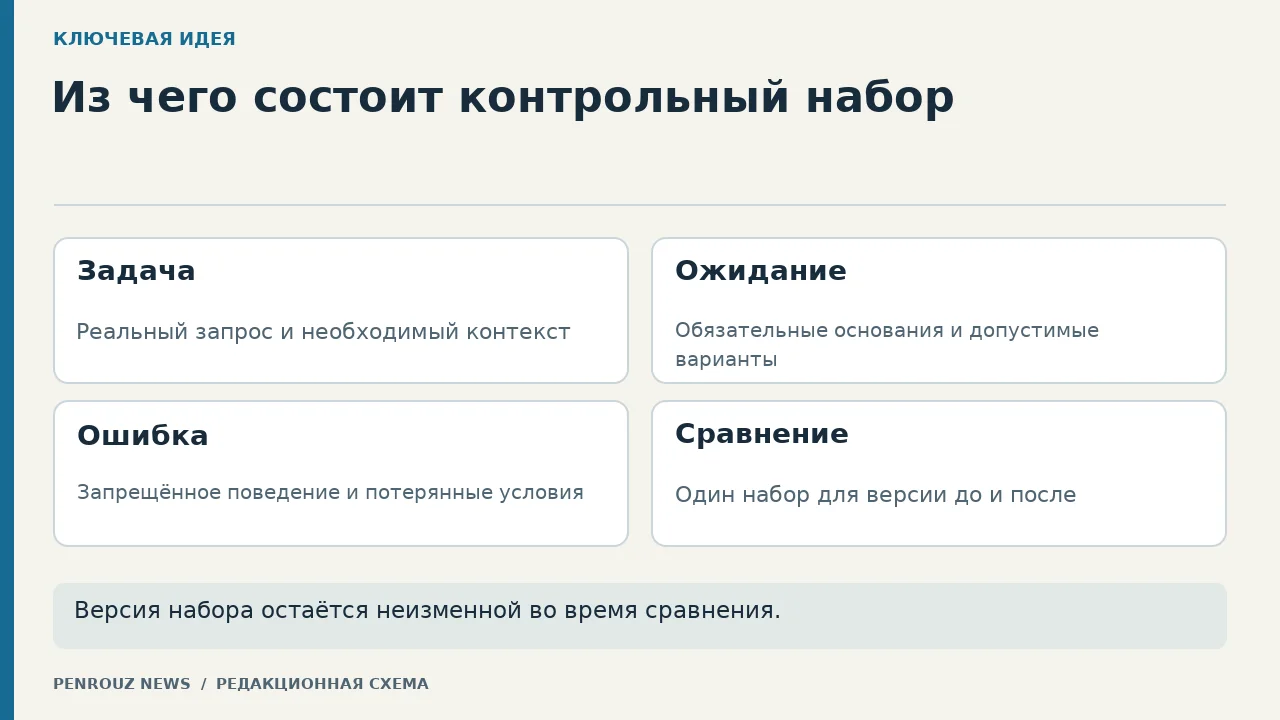
Контрольный набор делает изменения ИИ-системы сравнимыми: в каждом случае заранее фиксируют вход, обязательные признаки результата, допустимые варианты и ошибки, а одну версию набора прогоняют до и после изменения.
Короткий ответ: контрольный набор превращает впечатление в повторяемую проверку
Контрольный набор для оценки ИИ — это версия коллекции типовых задач, в которой заранее записаны входные данные, обязательные признаки правильного результата, допустимые варианты и критерии ошибки. Один и тот же набор запускают на системе до и после изменения промпта, модели, базы знаний или логики приложения. Сравнивают не общую «красоту» ответов, а прохождение тех же проверяемых случаев.
Такой набор часто называют golden set, эталонным или золотым датасетом. Название не означает, что у каждого задания существует единственная идеальная фраза. Для свободного текста полезнее зафиксировать смысловые инварианты: какие факты и основания должны присутствовать, что можно сформулировать по-разному и какое поведение считается ошибкой. Точное совпадение строки уместно только там, где формат действительно детерминирован.
Если нужно сначала разобраться в устройстве систем, начните с обзора про генеративный ИИ. Здесь задача уже практическая: собрать небольшой набор собственных случаев, на котором изменения можно сравнивать воспроизводимо.
Что должно быть в одном контрольном случае
Полезный случай начинается с реальной задачи пользователя, а не с абстрактного вопроса «ответь хорошо». Сохраните исходный запрос, доступный контекст и ограничения. Затем отделите ожидаемый результат от образцового текста: перечислите обязательные основания, допустимые варианты, запрещённые утверждения и способ проверки. У каждого случая должен быть стабильный идентификатор, чтобы результаты разных запусков можно было сопоставить.
Минимальная карточка контрольного случая
Поле
Что записать
Зачем
case_id
Стабильный идентификатор
Связать один случай между запусками
input
Запрос и необходимые исходные данные
Воспроизвести одинаковое условие
must_have
Обязательные факты, действия или основания
Проверить содержательную полноту
acceptable_variants
Разрешённые формулировки и варианты результата
Не штрафовать корректную вариативность
must_not
Недопустимые утверждения или действия
Выделить критические ошибки
check
Правило, рубрика или ручная приёмка
Сделать решение объяснимым
Это пример карточки контрольного случая. Поля можно адаптировать к задаче, сохраняя разделение входа, ожиданий и ошибок.
Контекст включают только тот, который доступен системе в реальном запуске. Если ответ должен опираться на документ, приложите конкретный фрагмент или идентификатор версии. Если задача проверяет отсутствие данных, не подсовывайте скрытую подсказку в описании ожидаемого ответа. Контрольный случай должен воспроизводить условия работы, а не давать оценщику преимущество, которого нет у приложения.
Ожидаемый результат лучше делить на три слоя. Первый — обязательные инварианты: например, назвать подтверждённое правило и сослаться на основание. Второй — допустимая вариативность: порядок пунктов, нейтральные синонимы, краткое или развёрнутое объяснение. Третий — ошибки: выдуманный факт, потерянное ограничение, неподтверждённое действие или неверный формат. Такое разделение позволяет оценивать смысл без требования дословно повторить эталон.
Для отдельного готового текста полезна оценка по рубрике. Контрольный набор решает другую задачу: он хранит много стабильных случаев и позволяет сравнить две версии системы на одинаковых входах.
Как подобрать случаи без ложного разнообразия
Начните с карты реальных задач и известных классов ошибок. В маленьком наборе важнее покрыть разные причины провала, чем собрать десятки перефразировок одного простого запроса. Добавьте нормальный путь, неполные данные, противоречие в источниках, пустой результат, требование к формату и случай, в котором система должна честно отказаться от вывода. Для диалоговой системы нужен хотя бы один случай с контекстом предыдущего хода.
Учебный мини-набор для справочной службы библиотеки
ID
Вход
Ожидаемый инвариант
Ошибка
lib-01
Найти часы работы по приложенной памятке
Назвать часы и указать раздел памятки
Придумать расписание без основания
lib-02
Та же просьба другими словами
Сохранить те же факты и основание
Изменить сведения из-за перефразировки
lib-03
В памятке нет праздничного режима
Сообщить, что данных недостаточно
Додумать праздничные часы
lib-04
Два фрагмента противоречат друг другу
Показать конфликт и запросить уточнение
Молча выбрать удобный вариант
lib-05
Вернуть результат в трёх полях
Соблюсти заданную структуру
Добавить неподдерживаемые поля
Все названия и ситуации учебные. Таблица показывает разнообразие условий, а не результат испытания конкретной системы.
Перефразировки полезны, если они проверяют устойчивость к длине, порядку условий или косвенной формулировке. Они не должны становиться искусственным способом увеличить набор. Два почти одинаковых входа с одним и тем же ожидаемым поведением дают меньше информации, чем один случай с отсутствующими данными или противоречием. Дубликаты нужно отмечать и удалять, чтобы один тип задачи не получил скрытый лишний вес.
Не смешивайте в одном case_id несколько независимых результатов. Если запрос одновременно требует извлечь факт, применить правило и выполнить действие, разделите проверку на наблюдаемые части либо создайте несколько случаев. Иначе непонятно, почему пример провален: из-за поиска основания, рассуждения, формата или действия.
Копируемый шаблон контрольного случая
Шаблон JSONL для одного случая
{"case_id":"lib-03","task":"Ответь о праздничном режиме библиотеки","context":{"document":"В памятке указан только обычный режим"},"must_have":["явно сообщить об отсутствии данных","предложить способ уточнения"],"acceptable_variants":["краткий ответ","ответ со списком"],"must_not":["выдумать часы","выдать обычный режим за праздничный"],"check":{"type":"rubric","review_fields":["grounding","completeness","format"]},"tags":["missing-data","grounding"],"dataset_version":"golden-01"}
JSONL удобен тем, что каждый объект остаётся самостоятельным и хорошо сравнивается в системе контроля версий. Но формат файла вторичен: таблица также подходит, если в ней однозначно хранятся вход, ожидания, ошибки, теги и версия. Важно не держать правила только в голове оценщика. Иначе одинаковый ответ при одной проверке может получить «пройдено», а при следующей — «ошибка» без объяснимой причины.
До автоматической оценки основания каждого ответа стоит проверять отдельно. Это помогает не смешивать корректность фактов с тоном, длиной и оформлением.
Как оценивать свободный ответ
Точное совпадение текста подходит для кода состояния, идентификатора или строго заданного поля. Для объяснения оно слишком хрупкое: два корректных ответа могут отличаться порядком предложений и словами. Поэтому проверяйте обязательные инварианты отдельно от стиля. Например, факт и ссылка на основание могут быть двумя бинарными условиями, а ясность — отдельным критерием оценки.
Автоматическая проверка полезна для схемы JSON, наличия обязательных полей, запрещённых значений и простых связей. Смысловые критерии требуют либо понятной рубрики и независимой ручной приёмки, либо отдельного оценщика с сохранённым обоснованием. В обоих случаях выборка спорных результатов должна оставаться доступной человеку. Единственный агрегированный балл без списка проваленных case_id скрывает причину регрессии.
Для каждого запуска сохраняйте версию системы, версию набора, идентификатор случая, статус, категорию ошибки и наблюдаемые основания решения. Тогда сравнение «до и после» превращается в перечень изменений: какие случаи исправлены, какие сломались и какие остались неопределёнными. Если оценщик не уверен, полезнее статус «нужна проверка», чем принудительное прохождение или провал.
Версии набора и защита от подгонки
Во время сравнения версия набора должна быть неизменной. Нельзя переписать ожидаемый результат после того, как новая система провалила случай, только чтобы превратить ошибку в успех. Если критерий действительно оказался двусмысленным, зафиксируйте причину, выпустите следующую версию набора и заново запустите обе сравниваемые системы.
Рабочие случаи, на которых команда исправляет промпт или логику, полезно отделить от отложенных проверочных случаев. Частое изучение ответов постепенно учит разработчиков проходить именно знакомые примеры. Отложенная часть помогает проверить, переносится ли улучшение на похожие, но не использованные при настройке условия. Состав обеих частей должен отражать реальные сценарии и известные ошибки, а не удобство текущей реализации.
Пополняйте набор из подтверждённых сбоев, новых типов задач и изменений продукта. Каждый новый случай проходит редактуру: есть ли реальный вход, однозначны ли основания, не дублирует ли он существующий пример, понятен ли критерий ошибки. Просто добавлять все журналы подряд нельзя: в них могут быть персональные данные, неоднозначные ожидания и случайный шум.
Если система отвечает по внутренним документам, следующим шагом станет подготовка базы знаний для RAG. Но контрольный набор остаётся самостоятельным активом: он проверяет результат для пользователя и помогает заметить регрессию после изменения поиска, промпта или модели.
Практический порядок запуска
Опишите один читательский или рабочий результат и перечислите реальные типы входов.
Выберите разные классы ошибок: пропуск основания, выдумка, потеря ограничения, неверный формат, отказ при наличии данных.
Заполните карточки случаев и согласуйте обязательные инварианты до запуска сравниваемых систем.
Проверьте дубликаты, неоднозначные задания и утечку ожидаемого ответа во входной контекст.
Заморозьте версию набора и прогоните обе системы на одинаковых входах.
Сохраните результаты по каждому case_id, а не только сводный балл.
Разберите исправления и регрессии; спорные критерии меняйте только в новой версии набора.
Добавляйте подтверждённые новые сбои, сохраняя отдельную отложенную часть для проверки.
Готовый первый набор не обязан быть большим. Он полезен, если случаи представляют разные реальные задачи, ожидания проверяемы, а повторный запуск даёт сопоставимый отчёт. Начните с небольшого ядра, которое команда действительно понимает и готова поддерживать. Затем расширяйте покрытие по журналам ошибок и новым сценариям, а не по абстрактному желанию увеличить число строк.
Примеры для библиотеки вымышлены. Они показывают структуру контрольного набора, а не результаты тестирования конкретной модели, сервиса или датасета.