Короткий ответ: LoRA обучает добавку, а не полную копию модели
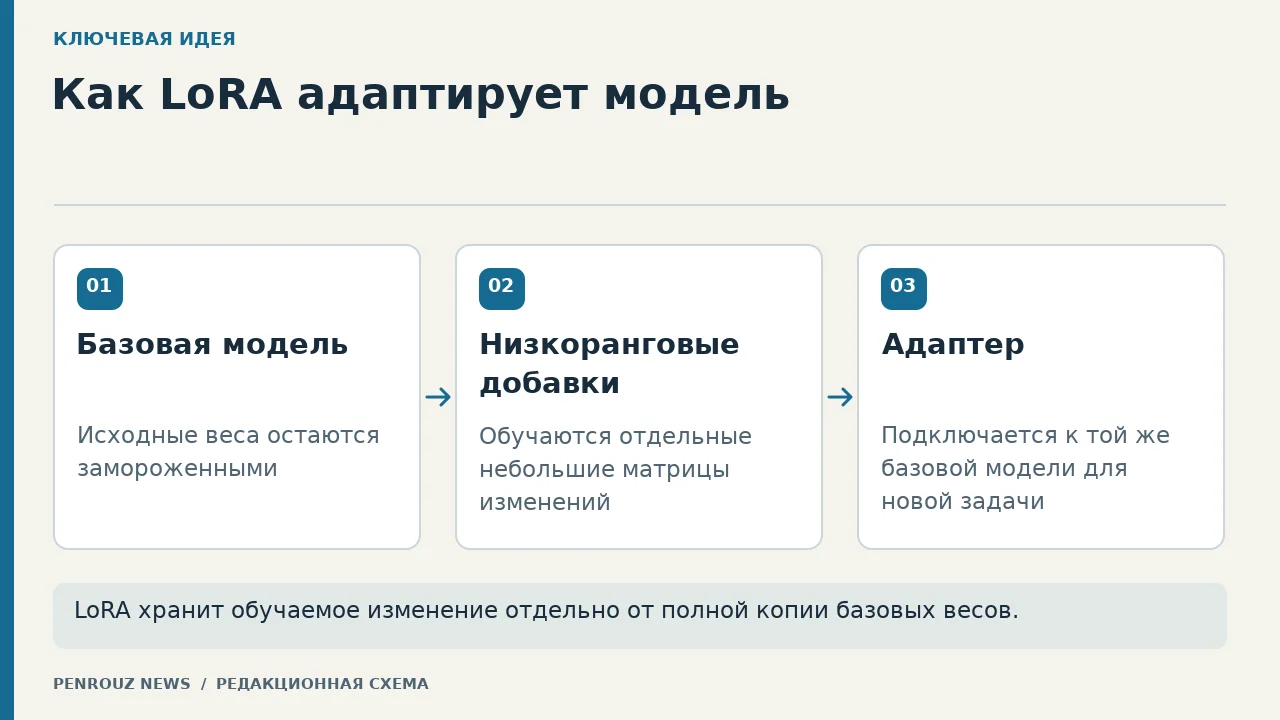
LoRA — способ адаптировать заранее обученную модель, оставив её исходные веса замороженными и обучая отдельное изменение небольшой структуры. Название расшифровывается как low-rank adaptation, то есть низкоранговая адаптация. Практический смысл состоит в разделении общей базовой модели и компактного набора обучаемых параметров для конкретной задачи. Такой набор обычно называют адаптером.
Во время использования адаптер подключают к той же базовой модели, чтобы вычисление учитывало выученное изменение. Сам файл адаптера не является полной моделью: без подходящей базы, той же архитектуры и согласованного способа подключения он не воспроизводит результат. Поэтому выражение «скачать LoRA-модель» лучше уточнять: часто речь идёт об адаптере, который предполагает отдельные базовые веса.
Если сначала нужно понять, какие части есть у языковой модели и как она выбирает продолжение, начните с разбора большой языковой модели.
Как работает низкоранговая добавка
Полное дообучение меняет множество исходных параметров. LoRA вместо этого представляет изменение выбранного слоя как произведение двух матриц меньшей внутренней размерности. При обучении изменяются параметры этих матриц, а базовые веса остаются фиксированными. В итоговом вычислении низкоранговая добавка корректирует результат исходного слоя. Ранг здесь описывает ограниченную внутреннюю размерность представления изменения, а не оценку качества модели.
Такое ограничение задаёт форму обучаемого изменения. Оно не доказывает, что любая задача укладывается в малый ранг, и не гарантирует качество без проверки. Выбор слоёв, данных и критерия приёмки остаётся частью эксперимента. LoRA экономит способ хранения и обучения изменения относительно общей базы, но не отменяет содержательную постановку задачи.
База, полное дообучение и LoRA-адаптер
Объект
Что хранится
Что меняется
Что нужно для воспроизведения
Базовая модель
Полный исходный набор весов
Ничего в LoRA-сценарии
Архитектура, веса и токенизатор
Полностью дообученная копия
Полный набор изменённых весов
Выбранные или все параметры
Версия весов и конфигурация
LoRA-адаптер
Низкоранговые добавки
Параметры добавок
Точная база, адаптер и правило подключения
Концептуальное сравнение без привязки к определённой библиотеке или формату файла.
Чем LoRA отличается от полного fine-tuning
Оба подхода используют обучающие примеры и меняют поведение модели, но сохраняют результат по-разному. Полное дообучение создаёт новую версию исходных весов либо изменяет значительную их часть. LoRA сохраняет базу общей и выносит обучаемое изменение в отдельный адаптер. Несколько задач могут использовать одну базу и разные адаптеры, если соответствие каждого базе явно зафиксировано.
Это различие не превращает LoRA в замену эксперименту. Нужны согласованные пары входа и ожидаемого ответа, отдельная проверка и baseline без адаптации. Общий выбор между промптом, поиском и изменением весов разобран в материале про обучение локальной нейросети.
Что входит в адаптер и чего в нём нет
В адаптере находятся параметры добавок и служебная конфигурация, позволяющая понять, куда их подключать. В нём обычно нет полной копии базовых весов, исходного набора данных и доказательства качества. Название файла тоже не гарантирует правильное подключение. Для передачи результата записывают идентификатор базы, архитектуру, целевые слои, способ подготовки входа и версию проверки.
Адаптер не является базой знаний. Если задача требует отвечать по меняющимся документам, хранить факты внутри весов неудобно: обновление знания потребует нового обучения. Для таких задач сначала рассматривают поиск и подстановку найденных фрагментов. LoRA уместнее обсуждать, когда требуется устойчиво изменить формат или повторяемое поведение, которое нельзя надёжно задать одной инструкцией.
Учебный пример: два поведения на одной базе
Представим вымышленную команду, которая адаптирует одну базовую модель для двух учебных задач. Первый адаптер должен возвращать одну из трёх меток обращения: «доставка», «оплата» или «возврат». Второй должен превращать короткую заметку в два поля JSON. База одна, но наборы примеров, правила ответа и адаптеры различаются. Пример не описывает запуск конкретной библиотеки и не содержит измеренных результатов.
Сначала команда фиксирует ответы неизменённой базы на закрытом наборе примеров. Затем для каждого адаптера готовит отдельные данные и критерий приёмки. После обучения она подключает один адаптер за раз и повторяет ту же проверку. Если качество выросло лишь на знакомых формулировках, а на закрытых примерах упало, компактность файла не делает эксперимент успешным.
Шаблон карточки LoRA-эксперимента
{
  "base_model": "точный идентификатор базы",
  "reader_task": "одно проверяемое поведение",
  "train_examples": "набор без тестовых примеров",
  "adapter_scope": "слои с добавками",
  "baseline": "ответы базы без адаптера",
  "acceptance": "критерий до обучения",
  "connection": "база, токенизатор, подключение",
  "rollback": "отключить адаптер"
}
Как проверить LoRA-адаптер
Проверяйте не размер файла, а выполнение задачи. Сравните базовую модель и вариант с адаптером на одинаковом закрытом наборе. Отдельно посчитайте полезную метрику, нарушения формата и ошибки редких сценариев. Сохраните примеры неудач: одно среднее число не показывает, какие случаи модель стала решать хуже. Если адаптеров несколько, тестируйте каждый с той базой, для которой он подготовлен.
После обучения следите за разрывом между знакомыми и новыми примерами. Если адаптер воспроизводит учебные формулировки, но теряет качество на независимой проверке, это признак проблемы данных или переобучения. Пошаговую диагностику такого разрыва продолжает материал о переобучении нейросети.
Для устойчивой приёмки соберите контрольный набор до настройки и не используйте его как подсказку при каждом изменении. Как отделить примеры разработки от финальной проверки, объясняет руководство по контрольному набору для оценки ИИ.
Типичные ошибки
Называть адаптер самостоятельной моделью и не указывать точную базу.
Считать малый файл доказательством качества или универсальной экономии.
Смешивать несколько несвязанных результатов без отдельной проверки.
Оценивать только на примерах, участвовавших в настройке.
Хранить меняющиеся факты в весах, когда задачу лучше решает поиск.
Передавать адаптер без конфигурации, критерия приёмки и истории данных.
Практический итог
LoRA полезно понимать как отдельный обучаемый слой изменений поверх общей базы. Вход процесса — базовая модель, данные одной задачи и правило проверки; результат — адаптер и конфигурация его подключения. Для честного сравнения нужны baseline, закрытый набор и проверка соответствия базе. Если эти части не зафиксированы, компактный файл остаётся артефактом без воспроизводимого результата.
Первичная работа, предложившая LoRA, описывает замораживание весов заранее обученной модели и добавление обучаемых матриц низкорангового разложения. Текущий материал использует этот механизм как устойчивое объяснение и не переносит точные результаты её экспериментов на другую модель или задачу.