Токенизация текста: как строка превращается в субслова и идентификаторы
Токенизатор делит строку по правилам своего словаря и переводит выбранные сегменты в числовые идентификаторы. Разбираем путь от текста до входа модели на проверяемом учебном примере.
Короткий ответ: токенизация переводит строку в последовательность идентификаторов
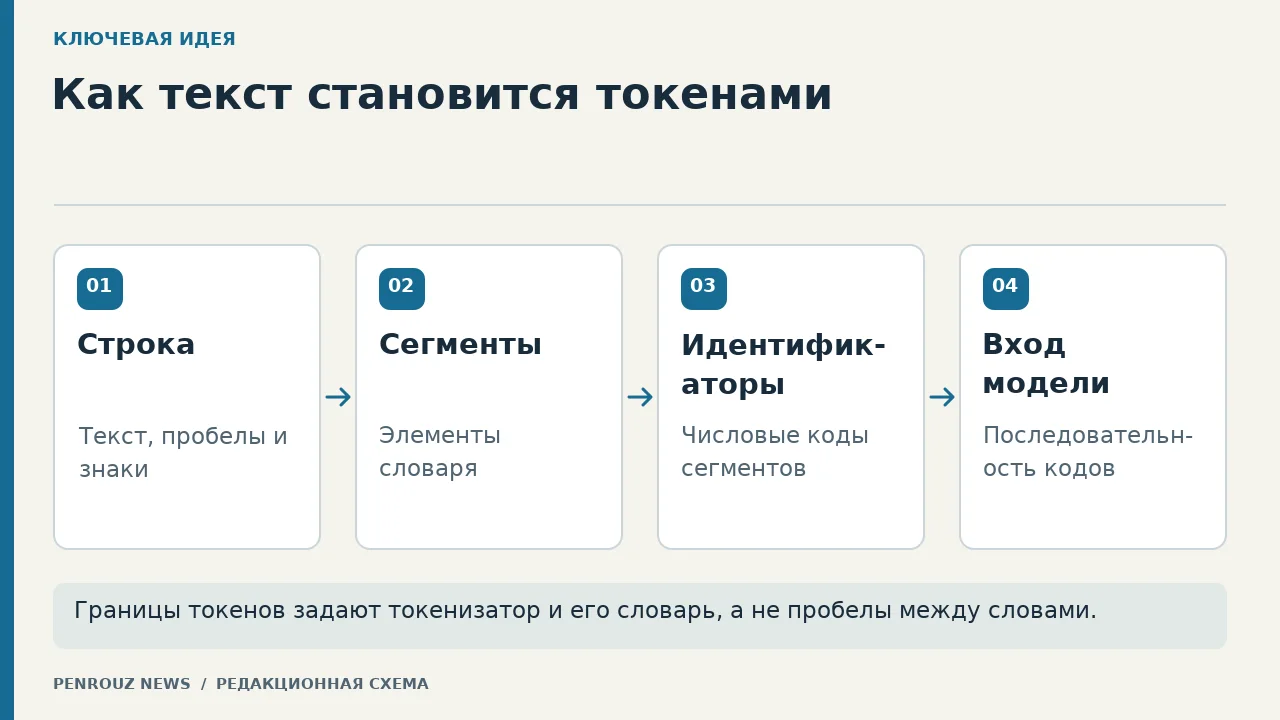
Токенизация — это подготовительный этап: исходная строка разбивается на элементы из заданного словаря, а каждый элемент заменяется числовым идентификатором. Токеном может оказаться целое короткое слово, часть слова, знак препинания, пробел или специальный служебный элемент. Поэтому границы токенов не обязаны совпадать с пробелами. Результат токенизатора — не смысл текста и не готовый ответ, а упорядоченная последовательность кодов, с которой дальше работает модель.
Эта задача уже, чем общий вопрос про токены и контекстное окно: здесь нас интересует именно правило сегментации и переход к идентификаторам, а не лимит запроса. Практический вывод прост: нельзя надёжно оценить токены только по словам или символам, пока неизвестны конкретный токенизатор и его словарь.
Что делает токенизатор
Сначала текст приводится к форме, которую умеет обрабатывать выбранный алгоритм. В зависимости от его правил могут учитываться регистр, пробелы, составные символы и служебные границы. Затем токенизатор ищет допустимое разбиение строки на элементы словаря. Одни методы последовательно объединяют часто встречающиеся части, другие строят вероятностную модель сегментов, третьи используют готовые правила. Для читателя важен общий инвариант: сегментация определяется не интуицией человека, а зафиксированными данными и процедурой токенизатора.
После сегментации каждый элемент заменяется идентификатором. На следующем этапе идентификаторы связываются с числовыми представлениями, и уже тогда начинается собственно обработка последовательности. Общую цепочку от входа до продолжения раскрывает материал о том, как работает большая языковая модель; здесь мы останавливаемся на её входной границе.
Зачем нужны субслова
Словарь из всех возможных слов был бы огромным и всё равно не покрывал бы новые формы, имена, опечатки и редкие термины. Субсловный подход ищет компромисс. Частые последовательности могут храниться целиком, а редкие слова собираются из более коротких элементов. Например, знакомая основа и окончание способны получить разные токены. Это позволяет представить строку элементами конечного словаря, не заявляя, что разбиение совпадает с морфемами русского языка. Субслово — технический сегмент, а не обязательная лингвистическая единица.
Длина сегментов влияет на длину входной последовательности. Если словарь хорошо покрывает часто встречающийся текст, многие участки представляются крупными элементами. Незнакомое написание может распасться на большее число частей. Отсюда не следует, что короткое разбиение всегда лучше: словарь и правила выбираются для работы всей системы, а не для экономии на одной строке. Сравнивать два токенизатора нужно на одном корпусе и по заранее выбранным критериям, а не по одному эффектному примеру.
Словарь и идентификаторы
Словарь сопоставляет допустимому элементу целое число. Само число не сообщает читателю значение: идентификатор 17 не «ближе» по смыслу к 18, чем к 900. Это всего лишь адрес элемента в словаре. Числовой код затем используется для выбора соответствующего представления. Поэтому при переносе сохранённой последовательности между разными токенизаторами нельзя ожидать того же текста: одинаковые числа могут указывать на другие элементы, а одинаковая строка — получать другое разбиение.
Не следует смешивать идентификатор токена и embedding. Идентификатор выбирает запись, а векторное представление несёт числовые признаки, с которыми работает модель. Отдельный разбор векторных представлений помогает понять следующий этап, но не меняет задачу токенизации.
Учебный пример: разбираем строку по вымышленному словарю
Возьмём строку «нейросетью!». В учебном словаре есть элементы «нейро», «сеть», «ю» и «!». Им назначены идентификаторы 17, 42, 8 и 3. Правило тоже задано заранее: двигаться слева направо и на каждой позиции выбирать самый длинный элемент словаря, который совпадает с оставшимся началом строки. Сначала подходит «нейро», затем «сеть», после неё «ю» и в конце знак «!». Получается последовательность сегментов [«нейро», «сеть», «ю», «!»] и кодов [17, 42, 8, 3].
Ручная проверка учебной сегментации
Шаг
Остаток строки
Выбранный элемент
ID
1
нейросетью!
нейро
17
2
сетью!
сеть
42
3
ю!
ю
8
4
!
!
3
Вымышленный словарь и идентификаторы; результат следует только из заданного правила самого длинного совпадения.
Пример проверяем без запуска модели: на каждом шаге выбранный элемент должен существовать в словаре, совпадать с началом остатка и быть не короче другого доступного совпадения. Конкатенация всех элементов должна точно восстановить исходную строку. Если удалить «сеть» из словаря, прежнее разбиение перестанет быть допустимым; понадобится другой набор более коротких частей либо явный элемент неизвестного фрагмента. Так видно, что результат зависит от словаря, а не только от текста.
Как проверить сегментацию
Зафиксируйте точную входную строку, включая регистр, пробелы и знаки.
Используйте именно тот словарь и те правила, для которых проверяется результат.
Убедитесь, что каждый полученный сегмент есть в словаре и имеет один определённый ID.
Передайте полученные ID декодеру этого токенизатора и сравните результат с ожидаемым текстом после его нормализации.
Выполните обратное преобразование ID в элементы и сравните с исходной сегментацией.
Отдельно проверьте редкое слово, смешанный алфавит, повторные пробелы и пунктуацию.
Для практического процесса полезно сохранять вход, название или контрольную сумму словаря, правила нормализации и выходные идентификаторы. Без этого два результата трудно сравнить: отличие может быть вызвано не текстом, а другим словарём или предварительной обработкой. Не называйте визуально похожие строки одинаковыми до проверки кодовых точек и нормализации. У некоторых токенизаторов декодер возвращает нормализованную строку: точное исходное написание и число пробелов не всегда восстанавливаются. Например, SentencePiece выполняет нормализацию до токенизации и по умолчанию сворачивает лишние пробелы; знак ▁ в его сегментах служит для представления пробелов. Важна воспроизводимость всей цепочки, а не только напечатанный список токенов.
Почему два токенизатора могут делить текст по-разному
Различия появляются из-за корпуса, на котором строился словарь, размера словаря, выбранного алгоритма, обработки пробелов и символов, а также специальных элементов. Один токенизатор может хранить частое слово целиком, другой — разделить его на основу и окончание, третий — использовать ещё более короткие части. Все варианты способны быть допустимыми в своих системах. Поэтому список токенов нельзя переносить между моделями как универсальную разметку. Сначала нужно установить владельца словаря и точные правила преобразования.
То же правило применимо к сборке входа: сначала фиксируют содержимое и назначение данных, затем считают их представление конкретным токенизатором. Руководство по контекстной инженерии разбирает, какие элементы вообще должны попасть во вход; токенизация отвечает уже за их техническое представление.
Что токенизация не делает
Токенизатор не проверяет истинность фразы, не определяет намерение пользователя и не гарантирует понимание текста. Он также не обязан находить лингвистически идеальные морфемы. Его работа заканчивается на согласованном представлении строки элементами словаря и идентификаторами. Качество ответа зависит от последующей модели, данных, инструкций и проверки. Поэтому успешное обратное восстановление строки подтверждает корректность преобразования, но ничего не доказывает о фактической точности будущего ответа.
Практический итог
Чтобы понять токенизацию, держите в голове четыре объекта: исходную строку, правила сегментации, словарь и последовательность идентификаторов. Проверка строится в обе стороны: ID сопоставляют элементам того же словаря, а результат декодера сравнивают с ожидаемым нормализованным текстом. Буквальное восстановление исходной строки в учебном примере не является общим правилом. Субслова позволяют представить редкие формы конечным набором элементов, но их границы остаются техническими. Учебный словарь вымышлен: он показывает преобразование строки в идентификаторы, а не результаты испытаний модели или библиотеки.