Контекстная инженерия: как собрать вход языковой модели
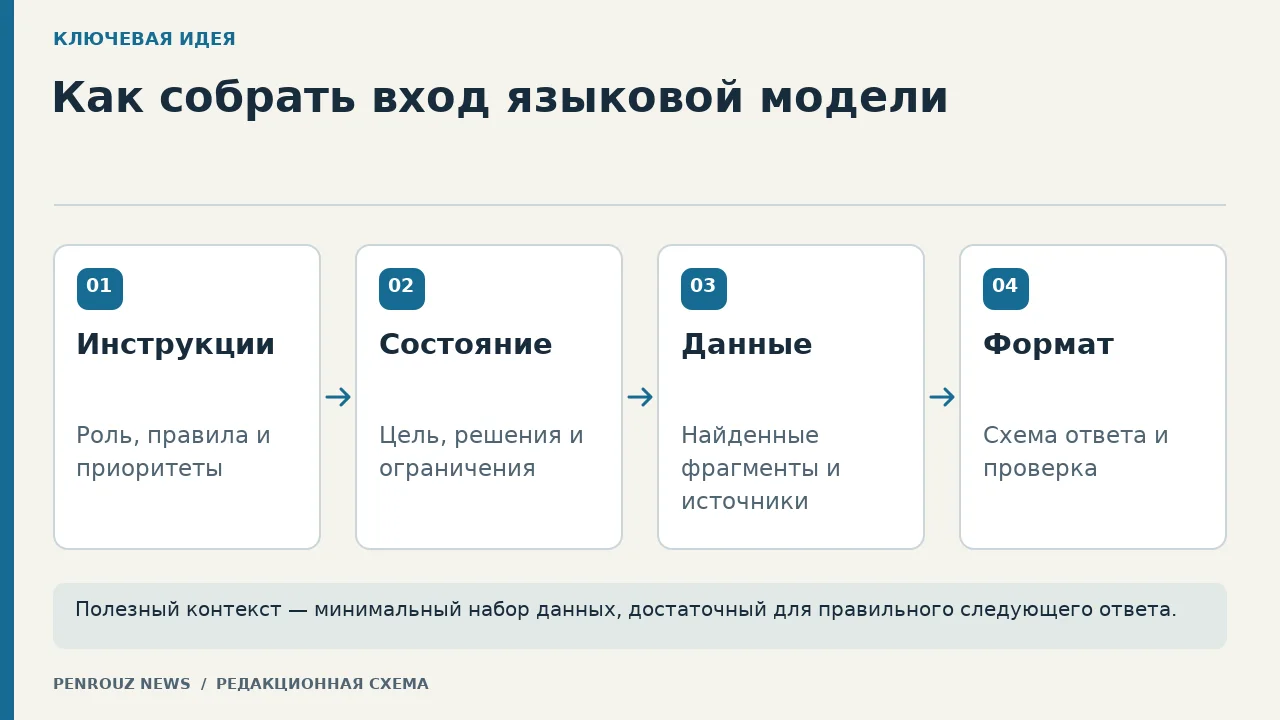
Контекстная инженерия собирает для каждого шага минимальный достаточный вход: инструкции, состояние задачи, релевантные данные, доступные инструменты и проверяемый формат ответа. Качество определяется не объёмом, а происхождением, приоритетом и полезностью каждого элемента.
В этом материале9 разделовРедакционная схема PENROUZ NEWS. Полезный контекст — минимальный набор данных, достаточный для правильного следующего ответа.PENROUZ NEWS
Короткий ответ: контекст — это собранный вход, а не один промпт
Контекстная инженерия — это проектирование набора информации, который языковая модель получает для конкретного шага. В него входят инструкции, текущее состояние задачи, найденные данные, описания доступных инструментов, примеры и требуемый формат результата. Цель — дать модели минимальный достаточный набор сигналов, чтобы она выполнила следующий шаг без догадок и лишнего шума.
Промпт-инженерия сосредоточена на формулировке задания и правил. Контекстная инженерия решает более широкую задачу: определяет, какие сведения вообще попадут во вход, откуда они взялись, какой имеют приоритет и когда должны быть удалены или заменены. Даже хорошо написанная инструкция не исправит отсутствующий факт, устаревшее состояние или нерелевантный фрагмент документа.
Начинать удобно с системного промпта и его границ: постоянные правила не должны смешиваться с пользовательскими данными и найденным содержимым. Контекстная инженерия связывает эти слои, но сохраняет их происхождение.
Из каких слоёв собирается контекст
Слои входа языковой модели
Слой
Содержимое
Главная проверка
Инструкции
Роль, правила, запреты и порядок приоритетов
Не смешаны ли правила с внешними данными
Состояние
Цель, принятые решения, ограничения и неизвестное
Соответствует ли текущему шагу
Данные
Фрагменты документов, результаты поиска и инструментов
Есть ли происхождение и релевантность
Инструменты
Доступные действия, параметры и условия применения
Не даны ли лишние возможности
Примеры
Небольшое число типовых входов и результатов
Показывают ли ожидаемое поведение
Формат
Схема ответа, обязательные поля и критерии приёмки
Можно ли проверить результат
Каждый слой имеет отдельное происхождение и жизненный цикл; порядок не превращает внешние данные в инструкции.
Состояние должно описывать текущую задачу, а не весь архив работы. Сохраняйте цель, последнее принятое решение, ограничения и открытые вопросы. Если значение можно однозначно получить из другого поля, его лучше вычислить при сборке. Дублирование создаёт риск, что две копии одного факта разойдутся и модель не поймёт, какая актуальна.
Найденные данные помещают в контекст вместе с идентификатором источника и границами цитируемого фрагмента. Внешний документ остаётся данными, даже если внутри него встречается фраза, похожая на команду. Это разделение помогает не принимать содержимое источника за правило поведения и позволяет проверить, на чём основан ответ.
Объём входа ограничивает контекстное окно, но большой доступный объём не означает, что его нужно заполнять. Длинный нерелевантный фон конкурирует с важными сигналами. Поэтому лимит токенов — техническая граница, а контекстная инженерия — выбор полезного содержимого внутри неё.
Как определить приоритеты и границы
Для каждого элемента задайте четыре свойства: источник, роль, срок применимости и шаг, которому он нужен. Постоянное правило может действовать во всей задаче; результат поиска — только до обновления документа; пример — лишь при генерации определённого формата. Явные границы позволяют удалять сведения после использования, не боясь потерять обязательное ограничение.
При конфликте не следует полагаться на порядок абзацев. Система сборки должна заранее решить, какой слой имеет право задавать правила, а какой только предоставляет данные. Пользовательское ограничение может уточнять задачу, но найденная веб-страница не должна менять разрешения инструмента. Неустранимый конфликт помещают в открытый вопрос и останавливают зависящий от него шаг.
Пошаговая сборка входного пакета
Определите один наблюдаемый результат текущего шага.
Добавьте минимальные постоянные инструкции и ограничения.
Загрузите актуальное состояние задачи без истории, которая уже свернута в решения.
Найдите только данные, необходимые для этого шага, и сохраните ссылки на происхождение.
Оставьте описания только тех инструментов, которые разрешены и действительно могут понадобиться.
Добавьте один или несколько канонических примеров, если формат трудно объяснить правилом.
Задайте структуру ответа и критерии приёмки.
Удалите дубли, устаревшие значения и фрагменты без роли.
Протестируйте пакет на обычном, неполном и конфликтном входе.
Поиск данных лучше выполнять по необходимости. Если заранее загружать все доступные документы, модель получает много фонового материала и меньше признаков того, что важно именно сейчас. Входной пакет может содержать лёгкие ссылки или идентификаторы, а подробные фрагменты подгружать после выбора следующего действия. Такой подход сохраняет проверяемость и уменьшает повторную передачу больших документов.
Векторная база помогает находить смыслово близкие фрагменты, но не решает вопрос включения автоматически. После поиска ещё нужно проверить соответствие задаче, версию, источник и достаточность фрагмента. Ретривер предлагает кандидатов; сборщик контекста решает, какие из них нужны текущему шагу.
Копируемый JSON-шаблон контекстного пакета
Пакет входа для одного шага
{
  "step_id": "draft-summary",
  "objective": "Сформировать краткое резюме подтверждённого документа",
  "instructions": {
    "role": "Редактор",
    "rules": [
      "Не добавлять факты без основания",
      "Отделять неизвестное"
    ]
  },
  "state": {
    "accepted_decisions": [
      "Использовать только подтверждённую версию"
    ],
    "open_questions": [
      "Нужен ли отдельный список терминов"
    ]
  },
  "context_items": [
    {
      "kind": "document_fragment",
      "source_ref": "artifact://policy-v3",
      "purpose": "Основание для резюме"
    }
  ],
  "tools": [
    {
      "name": "read_artifact",
      "allowed_for": [
        "artifact://policy-v3"
      ]
    }
  ],
  "output_schema": {
    "fields": [
      "summary",
      "unknowns",
      "source_refs"
    ]
  },
  "acceptance": [
    "Каждый факт имеет source_ref",
    "Неизвестное не заполнено догадкой"
  ]
}
Шаблон делает видимым назначение каждого элемента. context_items хранит не только текст, но и purpose: зачем фрагмент нужен текущему шагу. tools ограничивает доступные действия, а acceptance отделяет генерацию от проверки. Если элемент не помогает цели, не обеспечивает правило и не нужен для контроля результата, его можно удалить.
Как проверить контекст до запуска модели
Первая проверка — происхождение. Для каждого факта должно быть понятно, пришёл ли он от пользователя, из состояния, документа или инструмента. Вторая — актуальность: значение не заменено более поздним результатом. Третья — необходимость: без элемента модель действительно потеряет условие или основание. Четвёртая — безопасность границ: данные не получили роль инструкции.
Затем протестируйте поведение на трёх вариантах. В обычном случае пакет должен приводить к полному результату заданного формата. В неполном — модель должна назвать отсутствующее основание, а не заполнить его догадкой. В конфликтном — показать противоречие и не выполнять зависимое действие. Эти проверки выявляют не только слабость формулировки, но и ошибки сборки контекста.
Когда сохранять собранный контекст
Полный вход не обязательно хранить после каждого ответа. Полезнее сохранить структурированное состояние, ссылки на данные и результат приёмки. Тогда следующий шаг соберёт новый контекст из актуальных частей. Это предотвращает бесконечное накопление старых сообщений и позволяет менять формат представления без переписывания фактов.
Для длительной задачи принятый пакет состояния можно закрепить как контрольную точку ИИ-агента. Checkpoint отвечает за восстановление, а контекстная инженерия — за выбор частей этой точки и дополнительных данных для конкретного следующего вызова.
Типичные ошибки контекстной инженерии
Передавать весь архив сообщений вместо актуального состояния.
Смешивать инструкции и содержимое найденных документов.
Дублировать одно значение в нескольких слоях без владельца.
Добавлять все инструменты на случай, если они понадобятся.
Включать похожий фрагмент без проверки источника и версии.
Показывать десятки примеров вместо небольшого канонического набора.
Не задавать формат результата и критерии приёмки.
Хранить контекст после того, как его данные устарели.
Хороший пакет не обязательно самый короткий. Он минимален относительно результата: содержит все обязательные ограничения и основания, но не несёт частей, которые не меняют решение. Удаление важного поля так же вредно, как добавление большого нерелевантного документа. Поэтому оптимизация начинается с проверки роли каждого элемента, а не с механического сокращения числа токенов.
Практический итог
Контекстная инженерия превращает вход модели в проверяемый артефакт. Сначала определяется результат шага, затем отдельно собираются инструкции, состояние, данные, инструменты, примеры и формат. У каждого элемента фиксируются происхождение и назначение; конфликт остаётся открытым вопросом, а устаревшее удаляется. Такой пакет проще тестировать, обновлять и восстанавливать, чем неразделённую длинную переписку.
JSON-пакет вымышлен: он показывает структуру входа модели, а не результат запуска конкретного сервиса или агентной системы.