RLHF: как модель обучается на человеческой обратной связи
Редакционный разбор цикла RLHF: как сравнения ответов превращаются в модель предпочтений, что меняется на этапе оптимизации и как отделить обучающий сигнал от независимой проверки.
В этом материале9 разделовРедакционная схема PENROUZ NEWS. Обратная связь задаёт направление, но не заменяет независимую оценку результата.PENROUZ NEWS
Короткий ответ: RLHF превращает сравнения ответов в обучающий сигнал
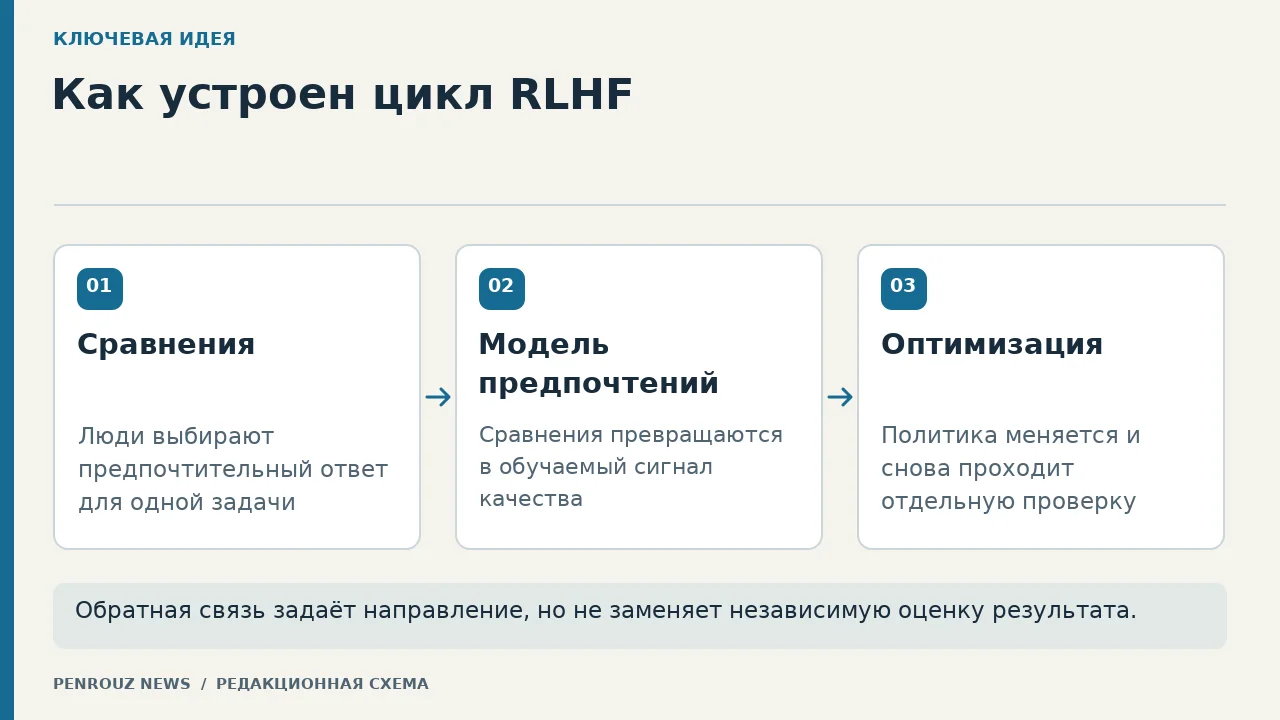
RLHF — это не «обучение на лайках» и не ручное переписывание каждого ответа. В типичном учебном представлении человеку показывают несколько вариантов ответа на одну и ту же задачу и просят выбрать предпочтительный. Из множества таких сравнений строят модель предпочтений: она учится приближённо предсказывать, какой вариант получит более высокую оценку. Затем этот сигнал используют, чтобы изменить поведение основной модели, не подменяя им отдельную приёмку результата.
Важна именно последовательность. Сравнение связывает выбор с конкретным запросом и двумя кандидатами; модель предпочтений обобщает эти решения; оптимизация меняет политику, то есть способ выбора следующего ответа. После изменения нужна новая проверка на заданиях, которые не использовались для настройки. Если смешать эти уровни, легко принять запоминание формулировок или стиль оценщиков за устойчивое улучшение.
Единица данных — не отдельный «хороший ответ», а карточка сравнения. В ней есть запрос, кандидат A, кандидат B, выбранный вариант и краткая причина выбора. Кандидаты должны отвечать на один и тот же запрос и получать одинаковый доступный контекст. Иначе предпочтение может отражать не качество ответа, а разницу входных условий.
Перед разметкой формулируют рубрику: какие свойства обязательны, какие допустимы, а какие являются ошибкой. Например, для ответа службы поддержки обязательны честное признание неизвестного и следующий проверяемый шаг; недопустимы выдуманная причина задержки и обещание срока без данных. Оценщик выбирает вариант по рубрике, а не по личной симпатии к более длинному или дружелюбному тексту.
Собирайте не только очевидные пары. Полезны близкие кандидаты, в которых различается одно существенное свойство: один сохраняет ограничение, второй его теряет; один признаёт неопределённость, другой додумывает причину. Такие пары лучше показывают, какой сигнал извлекается. Расхождения между оценщиками не надо скрывать: они указывают на неясную рубрику, неоднозначный запрос или реальную множественность допустимых ответов.
Этап 2. Обучить модель предпочтений
Модель предпочтений получает запрос и кандидат и возвращает относительную оценку, пригодную для сравнения вариантов. Её задача не написать ответ и не доказать его истинность. Она приближает закономерности в размеченных выборах. Если разметчики систематически предпочитают уверенный тон, модель может выучить тон как удобный признак даже там, где по задаче важнее осторожность.
Поэтому обучающие пары отделяют от контрольных. На обучающих данных настраивают модель предпочтений; на отложенных проверяют, сохраняется ли порядок на новых формулировках и новых типах кандидатов. Контроль должен включать спорные случаи и пары, где внешняя гладкость конфликтует с соблюдением ограничения. Один усреднённый балл не объясняет, какие именно предпочтения модель научилась воспроизводить.
Этап 3. Изменить политику и не потерять ограничения
На этапе оптимизации основная модель получает сигнал от модели предпочтений и сдвигает распределение ответов в сторону вариантов с более высокой оценкой. Здесь слово «политика» означает правило порождения ответа, а не отдельный документ с инструкциями. Конкретный алгоритм может различаться; для понимания механизма важнее сохранять границу: модель предпочтений оценивает, а политика генерирует.
Оптимизация по приближённому сигналу создаёт риск: политика может находить шаблоны, которые повышают оценку, но не улучшают реальный результат. Поэтому оценку ограничивают проверками на соблюдение исходной задачи, разнообразие формулировок, устойчивость к новым входам и отсутствие регрессий. Нельзя объявлять успех только потому, что вырос показатель, который использовался при настройке.
Чем RLHF отличается от обычного fine-tuning
Два типа обучающего сигнала
Подход
Что подают на вход обучения
Что модель учится делать
Главная проверка
Supervised fine-tuning
Запрос и эталонный ответ
Воспроизводить желаемый ответ или его структуру
Качество новых ответов на отложенных заданиях
RLHF
Запрос и сравнения кандидатов
Предпочитать поведение, согласованное с размеченными выборами
Устойчивость предпочтений и независимое качество результата
Схема упрощена: в реальном конвейере этапы могут сочетаться, но их сигналы и проверки полезно различать.
Fine-tuning на демонстрациях отвечает на вопрос «как выглядит желаемый ответ». Сравнения в RLHF отвечают на вопрос «какой из данных ответов предпочтительнее». Демонстрация даёт прямую цель воспроизведения, а пара — относительное решение. На практике демонстрации часто подготавливают исходную модель к задаче, а предпочтения уточняют поведение там, где трудно записать единственный эталон.
Учебный пример: два ответа на обращение
Представим вымышленную службу доставки. Клиент сообщает, что заказ задержан, но причина и новый срок неизвестны. Рубрика требует признать задержку, не выдумывать причину и предложить проверяемый следующий шаг. Это редакционный пример сравнения предпочтений, а не результат испытания модели.
Сравнение кандидатов по рубрике
Кандидат
Ответ
Разбор
A
«Вижу, что заказ задержан. Причина пока не указана; проверю актуальный статус и сообщу подтверждённую информацию».
Сохраняет неизвестное неизвестным и предлагает проверяемое действие
B
«Заказ задержан из-за перегрузки склада и точно будет завтра».
Добавляет причину и срок, которых нет во входных данных
Предпочтение A связано с ограничениями задачи, а не с длиной или эмоциональным тоном.
Шаблон карточки сравнения предпочтений
{
  "task": "ответ на обращение без выдуманных фактов",
  "prompt": "Клиент пишет: заказ задержан; причина неизвестна",
  "candidate_a": "Признаю задержку, не выдумываю причину, предлагаю проверить статус",
  "candidate_b": "Обещаю доставку завтра и называю причину без данных",
  "preferred": "candidate_a",
  "reason": "соблюдает ограничения и не добавляет неизвестное",
  "holdout_check": "новые формулировки обращения"
}
Проверяемая последовательность для такой карточки проста. Сначала заморозьте рубрику и входные данные. Затем перемешайте порядок кандидатов, чтобы позиция A или B не подсказывала выбор. Получите решение и причину. Отложите часть пар до завершения настройки. После оптимизации снова сгенерируйте ответы на новых формулировках и оцените их по той же рубрике, но независимым проходом.
Как проверить результат RLHF
Сформулируйте свойства результата до обучения: обязательные условия, запрещённые добавления и допустимые варианты стиля.
Разделите запросы, сравнения и причины на обучающий и контрольный наборы; не переносите контрольные пары в настройку.
Проверьте модель предпочтений отдельно: воспроизводит ли она порядок на новых парах и где расходится с рубрикой.
Проверьте политику отдельно: создаёт ли она ответы, которые проходят рубрику без подсказки готовыми кандидатами.
Сравните с базовой версией по каждому типу задачи, запишите исправления и регрессии, а спорные случаи разберите вручную.
Повторите проверку на новых формулировках и зафиксируйте версию рубрики, данных и решения.
Человеческий выбор не является абсолютной истиной. Оценщики могут по-разному понимать задачу, пропускать фактические ошибки, предпочитать знакомый стиль или уставать от длинных сравнений. Если рубрика расплывчата, модель предпочтений аккуратно воспроизведёт расплывчатость. Если кандидаты однообразны, она не научится различать ошибки, которых не видела.
Второе ограничение — разрыв между относительным выбором и самостоятельной генерацией. Легко выбрать лучший из двух слабых вариантов, но это ещё не означает, что политика создаст хороший ответ без пары для сравнения. Поэтому нужны оба режима проверки: ранжирование кандидатов и свободная генерация. В отчёте их результаты не следует сливать в одну оценку.
Третье ограничение — оптимизация по прокси. Модель предпочтений лишь приближает рубрику и решения людей. Чем сильнее политика подстраивается под этот прокси, тем важнее искать обходные паттерны: чрезмерные оговорки, шаблонные извинения, повторение ключевых слов рубрики или уверенный тон без основания. Эти эффекты выявляют не дополнительными обучающими лайками, а независимыми случаями и анализом ошибок.
Если цель — не только настроить поведение, но и воспроизводимо обучать собственную модель, границы данных и эксперимента полезно сверить с гайдом про обучение локальной нейросети.
Практический итог
Полезная схема RLHF держится на четырёх разделённых артефактах: карточках сравнений, версии рубрики, модели предпочтений и независимом отчёте о политике. Сравнения объясняют, что выбрали люди; модель предпочтений превращает эти решения в масштабируемый сигнал; оптимизация меняет генерацию; контрольный набор показывает, сохранился ли смысл улучшения за пределами обучающих примеров.
Начинайте не с алгоритма, а с одной чёткой задачи и нескольких пар, где причина предпочтения проверяема. Если нельзя объяснить выбор без слов «просто лучше», рано масштабировать разметку. Если показатель предпочтений растёт, а независимые ответы теряют условия или придумывают факты, меняйте рубрику и данные, а не объявляйте цикл завершённым.
Работы выше описывают ключевые идеи и экспериментальные реализации обучения по предпочтениям. Этот редакционный разбор не переносит их численные результаты на другие модели и не утверждает устройство закрытых систем: конкретные данные, алгоритмы и ограничения всегда проверяют по документации выбранного проекта.