Реранжирование фрагментов в RAG: как выбрать контекст
Реранжирование повторно оценивает кандидатов после поиска и поднимает фрагменты, которые прямо отвечают на вопрос. Разбираем границы этапа и проверку на вымышленном примере.
Короткий ответ: реранжирование уточняет порядок найденных фрагментов
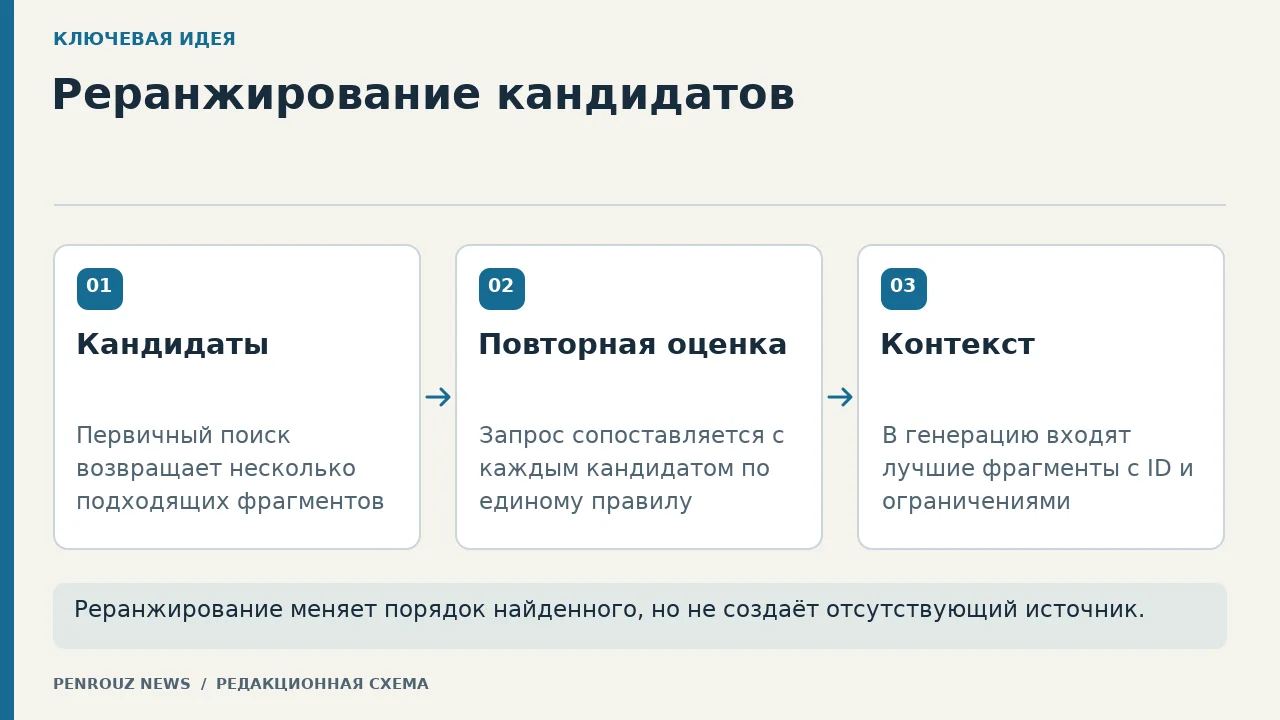
Реранжирование в RAG — это второй этап отбора после первичного поиска. На вход он получает вопрос и уже найденный список кандидатов, а на выходе возвращает тот же набор в новом порядке либо его сокращённую часть. Цель — поднять фрагменты, которые прямо отвечают на вопрос и сохраняют важные условия, выше текстов, лишь похожих по теме. Реранжировщик не ищет по всему корпусу заново и не создаёт источник, которого нет среди кандидатов.
Разделение этапов помогает диагностике. Первый поиск отвечает на вопрос «попал ли нужный фрагмент в пул», повторная оценка — «оказался ли он выше похожих, но менее полезных», а генерация — «сохранила ли модель смысл выбранного контекста». Если нужного документа нет в первичном пуле, улучшать только реранжирование бессмысленно. Если документ есть, но теряется внизу, второй этап действительно может быть точкой исправления.
До реранжирования нужен управляемый корпус и воспроизводимый первичный поиск. Базовую последовательность подготовки документов показывает гайд по базе знаний для RAG.
Где реранжирование стоит в цепочке RAG
Цепочка начинается с подготовки документов: фрагментам дают устойчивые идентификаторы, сохраняют источник, раздел, редакцию и другие ограничения. Затем retriever быстро возвращает небольшой пул кандидатов по лексическому, векторному или гибридному сигналу. Реранжировщик сопоставляет исходный вопрос с каждым кандидатом по единому правилу, меняет порядок и выбирает фрагменты для контекста. Генератор получает не безымянный текст, а выбранные записи с идентификаторами и сведениями об источнике.
Первичный поиск обычно оптимизирован на охват: важнее не пропустить возможный ответ. Повторный этап работает уже с ограниченным пулом, поэтому может внимательнее учитывать связь вопроса и каждого текста. Это не обязательно нейросетевая модель. Реранжирование может быть правилом, которое сохраняет точное исключение, отдаёт приоритет действующей редакции или исключает недоступный раздел. Если применяется модель попарной оценки, её результат всё равно нужно сочетать с обязательными фильтрами, а не заменять ими права доступа и версионность.
Как векторное хранилище возвращает кандидатов, исходный текст и метаданные, подробно разобрано в статье о векторной базе данных для RAG.
Что должно сохраниться между поиском и повторной оценкой
Каждый кандидат должен нести устойчивый ID, текст, ссылку на исходный документ, признаки редакции и причину попадания в пул. Для гибридного поиска полезно сохранить, из какого канала пришла запись и на какой позиции находилась. Реранжировщик может изменить порядок, но не должен превращать два появления одного ID в два независимых доказательства. Дубли объединяют до финального выбора, а сведения о происхождении оставляют в трассе.
Обязательные ограничения применяют до модели оценки либо проверяют сразу после неё. Нельзя поднимать закрытый документ только потому, что он семантически близок. Нельзя смешивать архивную и действующую редакции без явного запроса. Отдельно задают лимит контекста: сколько фрагментов, символов или смысловых частей реально войдёт в генерацию. Лимит кандидатов для реранжирования и лимит передаваемого контекста — разные решения.
Учебный пример: правила вымышленной библиотеки
Представим вымышленную библиотеку. Пользователь спрашивает: «Можно ли продлить книгу, если её уже забронировал другой читатель?» Первичный поиск возвращает четыре фрагмента. Их порядок ниже задан условно для объяснения и не является результатом запуска модели. Нужный ответ содержится в исключении, но общий текст о продлении оказался выше из-за тематической близости.
Кандидаты до и после повторной оценки
ID
Содержание
Первичный порядок
Решение реранжирования
В контекст
LIB-17
Книгу можно продлить один раз через личный кабинет.
1
Опустить: описывает действие, но не исключение.
Да, как дополнительное условие
LIB-42
Если на книгу есть бронь, продление недоступно.
3
Поднять: прямо отвечает на условие вопроса.
Да, первым
LIB-08
Срок обычной выдачи — две недели.
2
Опустить: тема похожа, ответа о продлении нет.
Нет
LIB-03
Читальный зал работает до закрытия здания.
4
Исключить: другой результат читателя.
Нет
Вымышленный пример. Позиции показывают логику проверки, а не измеренную выдачу сервиса.
После повторной оценки порядок начинается с LIB-42, затем идёт LIB-17. Генератор может ответить: продление недоступно при наличии брони [LIB-42]; если брони нет, оформление выполняется один раз через личный кабинет [LIB-17]. Из фрагментов нельзя узнать, есть ли бронь на конкретный экземпляр, поэтому это остаётся неизвестным. Такой ответ проверяем: каждое существенное условие связано с ID, а лишняя догадка не добавлена.
Шаблон трассы реранжирования
{
  "query": "исходный вопрос без переписывания смысла",
  "candidate_ids": ["ID-1", "ID-2", "ID-3"],
  "mandatory_filters": ["доступ", "действующая редакция"],
  "rerank_rule": "прямая связь с вопросом и сохранение исключений",
  "final_order": ["ID-2", "ID-1"],
  "context_limit": "обоснованный объём для генерации",
  "excluded": [{"id": "ID-3", "reason": "не отвечает на вопрос"}],
  "no_answer_rule": "если основания нет, сообщить об отсутствии"
}
Как проверять реранжирование отдельно от генерации
Соберите небольшой контрольный набор вопросов до настройки. Для каждого вопроса укажите допустимые фрагменты, явно неверные похожие записи и обязательные исключения. Сначала сохраните первичный пул. Затем сравните порядок до и после повторной оценки, не подключая оценку красивого финального текста. Проверка должна отвечать на три вопроса: был ли нужный фрагмент среди кандидатов, поднялся ли он выше тематического шума и не исчезло ли важное ограничение.
Добавьте разные типы случаев: прямой вопрос, перефразировку, точный код, условие с отрицанием, запрос к архивной редакции и вопрос без ответа в корпусе. Последний случай особенно важен. Реранжировщик не должен выбирать «наименее плохой» фрагмент как достаточное основание. Если все кандидаты лишь касаются темы, система должна сохранить возможность вернуть пустой результат и попросить уточнение.
Если кандидаты собираются из точного и смыслового каналов, сначала полезно разобраться, как они объединяются. Эту границу продолжает материал про гибридный поиск в RAG.
Как читать оценку кандидата
Число, выданное реранжировщиком, задаёт порядок по принятому правилу; оно не является вероятностью истинности документа. Высокая оценка не делает архивный текст действующим и не доказывает полноту ответа. Поэтому рядом с порядком сохраняют обязательные поля: редакцию, доступ, источник и причину исключения. Порог или размер финального списка выбирают по контрольным вопросам, а не переносят автоматически из чужого примера.
Попарная модель оценки читает вопрос и кандидат совместно и возвращает одно значение для пары. Такой подход способен внимательнее учитывать формулировку вопроса, чем независимое сравнение заранее рассчитанных представлений. Но он применяется только к уже ограниченному пулу: оценивать весь большой корпус по каждой паре было бы другой задачей. В качестве альтернативы остаются прозрачные правила и комбинации сигналов. Выбор метода проверяют по конкретным ошибкам корпуса.
Типичные ошибки
Пытаться реранжированием вернуть документ, которого нет среди кандидатов.
Смешивать оценку релевантности с правами доступа, версией или истинностью.
Считать один и тот же фрагмент из двух каналов двумя доказательствами.
Менять одновременно корпус, первичный поиск и реранжировщик, теряя причину улучшения.
Оценивать только финальный ответ и не сохранять порядок кандидатов.
Всегда передавать верхний результат, даже когда ни один кандидат не содержит основания.
Проверяемая последовательность внедрения
Сначала зафиксируйте контрольные вопросы и допустимые ID. Затем сохраните первичные кандидаты вместе с каналом, позицией, версией и доступом. Удалите дубли по устойчивому идентификатору. Примените одно правило повторной оценки к каждому вопросу, сохраните новый порядок и причины исключения. Ограничьте контекст, но не обрезайте фрагмент посередине важного условия. Только после этого подключайте генерацию и проверяйте, сохранила ли она выбранные основания.
При неудаче классифицируйте уровень ошибки. Нужный ID отсутствует — меняйте корпус, разбиение или retrieval. ID есть, но остаётся ниже общего текста — проверяйте повторную оценку и данные для неё. Правильный фрагмент выбран, но ответ искажён — исправляйте инструкцию и проверку генерации. Такой разбор предотвращает бесконечную настройку одного компонента за ошибки другого.
Реранжирование повышает шанс выбрать лучший фрагмент из уже найденных, но не гарантирует правильный ответ. Оно не исправляет отсутствующий документ, плохое разбиение, неверную редакцию, незаконный доступ или инструкцию внутри недоверенного текста. Повторная оценка также добавляет задержку и ещё одну точку наблюдения. Поэтому сохраняйте исходный и финальный порядок, версию правила, причины фильтрации и возможность вернуться к простому baseline.
Итоговая схема проста: retriever собирает кандидатов, обязательные фильтры удерживают границы допустимого корпуса, реранжировщик меняет порядок, а лимит контекста определяет, что увидит генератор. Полезный результат — не высокий score сам по себе, а воспроизводимый выбор фрагмента, который прямо отвечает на вопрос и сохраняет условия. Если основания нет, корректный выход — пустой контекст или честное сообщение об отсутствии ответа.