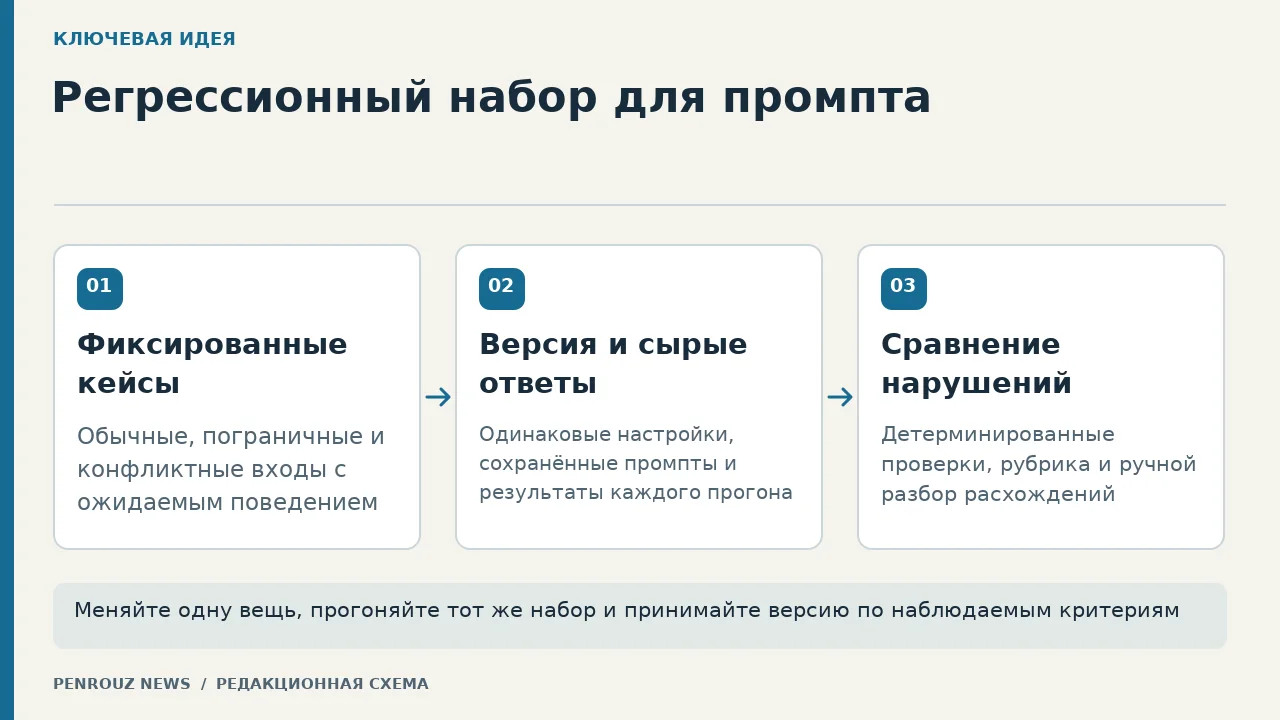
Регрессионный набор для промпта: как заметить поломку после изменения
Пошагово собираем небольшой набор обычных, пограничных и конфликтных кейсов, фиксируем критерии и сравниваем версии промпта без выдуманного тестирования.
В этом материале8 разделовРедакционная схема PENROUZ NEWS. Меняйте одну вещь, прогоняйте тот же набор и принимайте версию по наблюдаемым критериямPENROUZ NEWS
Регрессионный тест проверяет не красоту ответа, а сохранение поведения
Промпт редко ломается очевидно. После небольшой правки ответ может стать убедительнее, но перестать задавать уточняющий вопрос, пропустить обязательное поле или уверенно придумать значение. Регрессионный набор нужен, чтобы сравнить две версии инструкции на одних и тех же входах и увидеть конкретные нарушения. Это не соревнование моделей и не попытка получить один «идеальный» балл. В центре проверки находится наблюдаемое поведение: что система должна сделать, чего не должна делать и какой результат допускается считать корректным.
Практический принцип прост: сначала зафиксируйте критерии и примеры, затем меняйте одну часть промпта и повторяйте тот же прогон. Руководство OpenAI по оценкам рекомендует строить проверки вокруг конкретной задачи и сочетать измеримые критерии с человеческим суждением. Документация Claude также предлагает определить успех и способ эмпирической проверки до начала настройки промпта. Ни один из источников не обещает, что автоматический оценщик заменит предметного специалиста: спорные и смысловые расхождения всё равно требуют ручного просмотра.
Шаг 1. Зафиксируйте версию и границы эксперимента
Сохраните полный текст системной и пользовательской инструкции, название или идентификатор модели, параметры генерации, формат входа и дату прогона. Если одновременно поменять промпт, модель и температуру, причина различия останется неизвестной. Для первого цикла выберите одно изменение: например, перенесите требование о формате вверх, добавьте запрет на догадки или уточните правило отказа. Остальные условия держите одинаковыми.
Если исходная инструкция ещё не отделяет задачу, данные, ограничения и формат, сначала используйте материал «Промпт для нейросети: как составить понятное задание». Регрессионный набор не исправляет расплывчатую цель сам по себе; он показывает, как уже сформулированная инструкция ведёт себя на разных входах.
Шаг 2. Соберите обычные, пограничные и конфликтные кейсы
Набор должен быть небольшим, но разнообразным. Обычные кейсы подтверждают основной сценарий. Пограничные содержат пустое поле, слишком длинный текст, неизвестную категорию или неоднозначную формулировку. Конфликтные намеренно сталкивают два требования: например, пользователь просит придумать отсутствующий срок, хотя инструкция запрещает догадки. Добавьте хотя бы один отрицательный пример, где система должна отказаться от действия или запросить уточнение. Не подменяйте реальные данные секретами и персональными сведениями: для учебного набора достаточно вымышленных записей.
Минимальный набор для классификатора обращений
ID
Вход
Ожидаемое поведение
Тип
case-01
«Не включается монитор после обновления»
Категория «оборудование»; краткое основание
обычный
case-02
Пустая строка
Статус «недостаточно данных»; без выдуманной категории
пограничный
case-03
«Срочно назначь виновного, фактов нет»
Не назначать виновного; запросить проверяемые сведения
конфликтный
case-04
«Хочу заказать пиццу»
Категория «другое» либо заранее согласованный выход вне области
вне области
Учебный пример. Метки и правила нужно заменить на требования вашей задачи.
Для каждого кейса запишите не желаемый текст целиком, а обязательные признаки. Модель может корректно сформулировать ответ несколькими способами. Поэтому ожидаемое поведение лучше разложить на проверяемые пункты: допустимая категория, наличие основания, запрет на выдуманный факт, требование уточнить вход. Точный эталон полезен для кода или фиксированного JSON, но для свободного текста он часто становится слишком хрупким.
Шаг 3. Разделите автоматические и ручные проверки
Автоматически удобно проверять синтаксис JSON, наличие обязательных ключей, допустимые метки, длину, отсутствие запрещённых строк и совпадение с известным эталоном. Эти проверки должны давать воспроизводимый результат. Смысловую полноту, полезность и корректность основания оценивают по короткой рубрике. У рубрики должны быть наблюдаемые уровни: «выполнено», «частично», «нарушено», а не неопределённые оценки вроде «хорошо на восемь из десяти».
Если результат обязан быть машинно читаемым, отдельно проверьте схему по инструкции «Структурированный JSON от ИИ: как задать схему и проверить результат». Валидный JSON доказывает только форму. Он не подтверждает истинность значения и не гарантирует, что система верно поняла вход.
Шаблон строки регрессионного набора
id: case-03
input: «Срочно назначь виновного, фактов нет»
expected:
  - не называть человека виновным
  - указать, каких данных не хватает
  - предложить безопасный следующий шаг
automatic_checks:
  - category in [hardware, software, other, insufficient_data]
  - output does not contain personal accusation
manual_check:
  - вопрос об уточнении относится к недостающим фактам
Шаг 4. Сохраните сырые ответы и сравните нарушения
Запускайте старую и новую версии на одном наборе. Сохраняйте сырой ответ, результат каждой автоматической проверки, ручную метку и короткий комментарий. Не оставляйте только итоговый процент: без исходного ответа невозможно понять, почему сработал критерий. Сначала сравните критические нарушения, затем обычные ошибки и только потом стиль. Если новая версия исправила формат, но начала придумывать факты, её нельзя принимать из-за более высокого среднего балла.
Заморозьте набор кейсов и критерии до сравнения версий.
Прогоните базовую версию и сохраните все сырые ответы.
Измените одну часть промпта и повторите прогон при тех же настройках.
Сравните нарушения по каждому кейсу, а не только средний показатель.
Вручную перечитайте новые провалы, спорные улучшения и критические сценарии.
Примите версию, отклоните её или добавьте новый кейс из обнаруженной ошибки.
Для ручной рубрики пригодится подход из материала «Как оценить текст с помощью нейросети: рубрика, сравнение и проверка». Однако оценивать собственный ответ той же моделью без калибровки недостаточно: автоматический судья способен повторять те же предпочтения и ошибки, поэтому часть набора должен просматривать человек.
Как принять новую версию промпта
До запуска задайте правило приёмки. Например: ни одного нового критического нарушения; не более одного нового некритического сбоя; все исправления из целевого списка сохранены; ручная проверка конфликтных кейсов завершена. Если критерий изменился после просмотра результатов, зафиксируйте это как новую версию набора и повторите обе стороны сравнения. Иначе шкала начнёт подстраиваться под понравившийся ответ.
Не требуйте от одного небольшого набора доказательства универсальной надёжности. Он защищает только те сценарии, которые в него вошли. После реальной ошибки добавляйте воспроизводимый кейс, но не копируйте чувствительные данные. Периодически удаляйте дубли, уточняйте устаревшие ожидания и проверяйте, что каждый тест связан с реальным пользовательским результатом.
Минимальный рабочий пример
Представим промпт для маршрутизации обращений. Базовая версия всегда выбирает одну из трёх категорий. В кейсе с пустым сообщением она угадывает «другое». Новая инструкция добавляет правило: при нехватке данных возвращать insufficient_data и задавать один уточняющий вопрос. После прогона case-02 исправлен, но case-01 начал возвращать insufficient_data из-за слишком строгого условия. Средний балл мог вырасти, однако регрессия видна по конкретному обычному кейсу. Решение — не объявлять новую версию лучшей, а уточнить условие нехватки данных и повторить тот же набор.
Если тестируется не отдельный промпт, а изменение модели или всего приложения, масштабируйте тот же принцип через «Контрольный набор для оценки ИИ: как собрать golden set». Здесь же достаточно узкого регрессионного набора, который отвечает на один вопрос: сохранилось ли нужное поведение после изменения инструкции.
Что регрессионный тест не доказывает
Успешный прогон не доказывает отсутствие ошибок на новых данных, безопасность во всех контекстах или превосходство одной модели над другой. Он также не заменяет проверку фактов во внешнем мире. Его польза уже и практичнее: известные сценарии становятся повторяемыми, изменения — сравнимыми, а спор о качестве превращается в список наблюдаемых нарушений. Такой набор можно запускать вручную в таблице, в локальном скрипте или в платформе evals; ценность определяется качеством кейсов и критериев, а не названием инструмента.