Потоковые ответы API ИИ: как собрать текст и проверить завершение
Практический гайд по потоковой выдаче ответов модели: как обрабатывать типизированные события, собирать текст, отличать завершение от обрыва и проверять результат.
Потоковый ответ — это последовательность событий, а не готовая строка
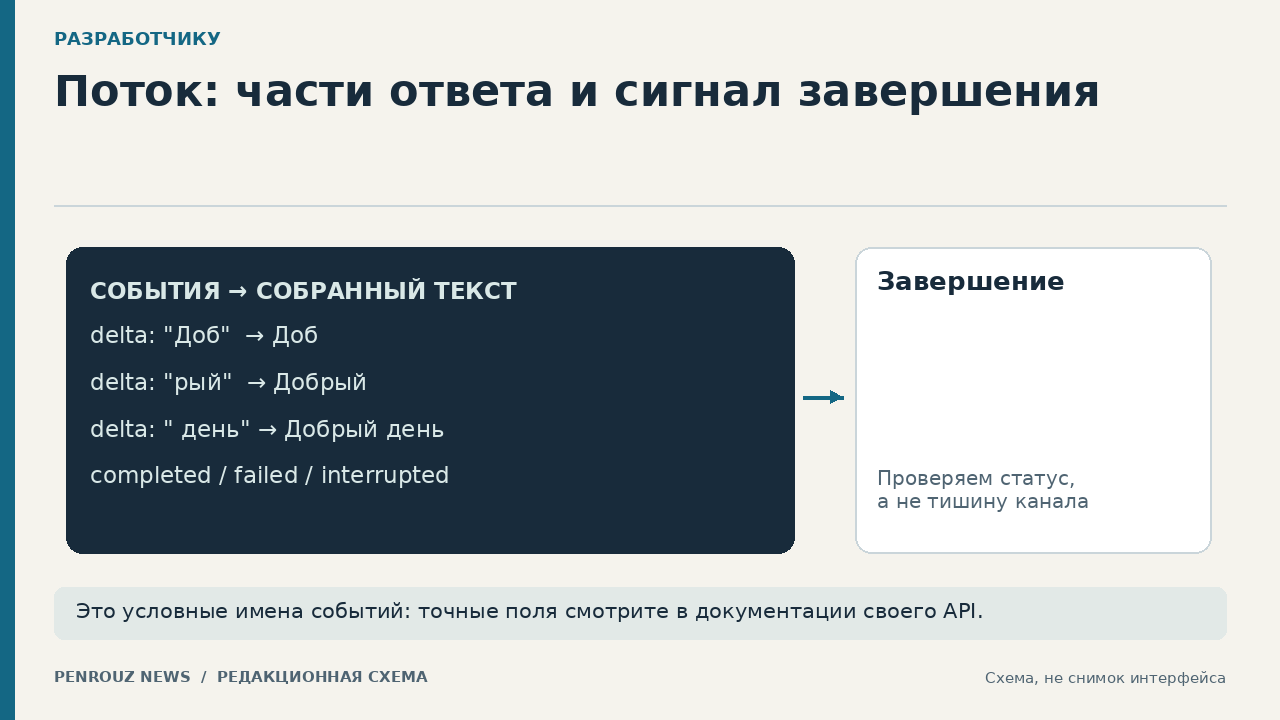
Потоковая выдача позволяет показать первые фрагменты ответа до завершения всей генерации, но меняет модель обработки. Клиент получает не один итоговый объект, а последовательность событий или частей ответа. Поэтому нельзя просто вывести каждый пришедший фрагмент и считать задачу законченной: приложение должно различать полезный текст, служебные события, ошибки и окончательное подтверждение завершения. Основная практическая цель — собрать один проверяемый результат и не перепутать частичный вывод с полным.
Для обычного текстового интерфейса достаточно завести состояние одного запроса: идентификатор, текущий статус, накопленный текст, время первого фрагмента, время завершения и описание ошибки. Каждый новый запрос должен иметь собственный контейнер состояния. Это предотвращает смешивание двух ответов, если пользователь повторно нажал кнопку, открыл вторую вкладку или предыдущий поток завершился позже нового. Отображение текста и фиксация окончательного результата должны быть разными операциями.
Сначала определите конечные состояния
До подключения интерфейса перечислите допустимые состояния: создан, идёт передача, завершён, прерван пользователем и завершён ошибкой. Терминальные состояния — завершён, прерван и ошибка — должны запрещать дальнейшее добавление фрагментов. Если поставщик передаёт типизированные события, ориентируйтесь на их типы, а не на наличие текста в произвольном поле. В документации OpenAI для Responses API отдельно показаны события с приращением текста, успешным завершением и ошибкой; у Google Interactions поток также имеет явный жизненный цикл.
Размер контекста и максимального ответа задаётся до запуска, поэтому полезно заранее сверить ограничения по материалу «Токены и контекстное окно ИИ». Поток не расширяет контекстное окно и не гарантирует, что модель закончит мысль до установленного предела. Если итог оборвался из-за лимита, интерфейс не должен помечать его как полноценный только потому, что соединение закрылось без сетевой ошибки. Храните причину остановки или финальный статус, когда API её предоставляет.
Собирайте только нужные события
Обработчик должен разбирать событие по типу и передавать его специализированной ветке. Текстовое приращение добавляется к буферу, событие создания сохраняет идентификатор, событие завершения закрывает поток и фиксирует метаданные, а ошибка переводит запрос в состояние неуспеха. Неизвестные типы безопаснее журналировать и игнорировать до обновления обработчика, чем пытаться трактовать их как текст. Такой подход устойчивее к появлению новых служебных событий в API.
У Google Interactions шаг начинается событием step.start, продолжается одним или несколькими step.delta и заканчивается step.stop; затем interaction.completed сообщает о завершении взаимодействия. Текст, изображения, вызовы функций и другие данные могут приходить как разные типы приращений. Это важное ограничение универсального обработчика: нельзя без проверки склеивать все поля delta. Например, arguments_delta представляет частичную JSON-строку аргументов функции, которую нужно накопить целиком, а не выполнять по первому фрагменту.
Не разбирайте частичный JSON как готовый объект
Если модель должна вернуть данные по схеме, используйте подходы из материала «Структурированный JSON от ИИ», но применяйте проверку после сборки полного значения. Отдельный фрагмент может заканчиваться внутри строки, числа или escape-последовательности и поэтому не обязан быть валидным JSON. Интерфейс может показывать текстовое представление, но бизнес-логику, запись в базу и вызов инструмента запускайте только после терминального события и успешного разбора накопленной строки.
Для потока аргументов функции заведите отдельный буфер по идентификатору вызова. Добавляйте каждый arguments_delta в порядке получения, а после завершения шага выполните синтаксический разбор и проверку обязательных полей. Даже валидный JSON ещё не означает безопасное действие: имя операции, диапазоны значений и полномочия нужно проверять отдельно. Если соединение оборвалось, частичные аргументы следует отбросить или сохранить только для диагностики, но не исполнять.
Обрыв соединения не равен завершению генерации
Сетевое соединение может закрыться после нескольких фрагментов, до финального события. Поэтому событие закрытия транспорта — это сигнал проверить состояние, а не автоматически отметить успех. Считайте результат завершённым только после предусмотренного API события завершения. Если финального события нет, покажите пользователю, что ответ неполный, сохраните идентификатор запроса и предложите безопасный повтор. Не дописывайте окончание локально и не объединяйте новый ответ со старым без явной стратегии.
Повтор потокового запроса может породить другой текст, поэтому простой повтор нельзя считать продолжением предыдущего результата. Для чтения пользовательского ответа безопаснее начать новую попытку и визуально отделить её. Для операций с внешними эффектами поток вообще не должен быть единственным подтверждением: используйте серверный статус операции, собственный ключ идемпотентности или отдельное подтверждение результата. Так интерфейс остаётся отзывчивым, но не превращает частичный вывод модели в факт выполненного действия.
Рабочий пример: поток для вымышленной справки
Представим вымышленный сервис, который составляет справку о правилах внутреннего книжного клуба. Запрос получает локальный идентификатор demo-17 и состояние created. После открытия потока состояние меняется на streaming. События с текстовыми приращениями последовательно добавляют фразы «Встреча проходит…», «каждую среду…» и «в 19:00». Интерфейс показывает растущий текст, но кнопка «Сохранить справку» остаётся неактивной, пока не получено терминальное событие.
Если приходит событие успешного завершения, приложение сохраняет итоговую строку, метаданные и время завершения, затем включает проверку и сохранение. Если вместо этого соединение закрывается после слов «каждую среду», состояние становится interrupted, а рядом появляется пометка «Ответ получен не полностью». Пользователь может запустить новую попытку, которая получит новый идентификатор. Такой пример легко воспроизвести тестовым генератором событий без настоящих персональных данных и без обращения к производственной системе.
Проверяйте не только текст, но и порядок событий
Минимальный тестовый набор должен включать успешный короткий поток, много мелких фрагментов, ошибку до первого текста, ошибку после нескольких фрагментов, закрытие без события завершения, повторное событие завершения и фрагмент после терминального состояния. Для каждого сценария заранее задайте ожидаемые статус, итоговую строку и число сохранений. Обработчик обязан игнорировать поздний фрагмент и не выполнять финализацию дважды. Это защищает от дублей при повторной доставке или ошибке интерфейсного кода.
После технической сборки примените к полному результату обычную содержательную проверку из статьи «Как проверять ответы ИИ». Потоковая доставка уменьшает ожидание первых символов, но не делает утверждения модели точнее. Факты, числа, даты и ссылки проверяются после завершения. Если важный вывод был показан пользователю до проверки, интерфейс должен ясно обозначать его как формирующийся черновик, а не как подтверждённый результат.
Учитывайте модерацию и отображение черновика
Потоковый интерфейс показывает содержание раньше, чем становится доступен полный ответ. Документация OpenAI отдельно предупреждает, что частичные завершения сложнее модерировать, а оценки, запрошенные вместе с генерацией, могут быть доступны только после готовности полного вывода. Практический вывод — не выдавать каждый фрагмент как окончательно одобренный материал. Для чувствительных сценариев можно временно буферизовать текст, показывать нейтральный индикатор или применять собственную проверку до публичного отображения.
Раскрытие участия ИИ должно сохраняться и для потоковой выдачи: пользователь должен понимать, что видит автоматически формируемый черновик. Не создавайте иллюзию сообщения, которое уже проверил человек. После завершения можно отдельно показать статусы «ответ собран» и «проверка выполнена». Такой интерфейс честно разделяет скорость доставки, техническую целостность и содержательную достоверность — три разных свойства результата.
Как убедиться, что реализация готова
Готовая реализация проходит проверку, если фрагменты собираются строго в порядке получения, служебные события не попадают в текст, успешный статус появляется только после терминального события, обрыв помечается как неполный ответ, ошибки сохраняются без утечки ключей и повторная финализация не создаёт дубль. Дополнительно измерьте время до первого текстового фрагмента и полное время запроса: первое показывает отзывчивость интерфейса, второе — фактическое завершение работы.
Последняя проверка проводится на вымышленном запросе с заранее известной контрольной строкой. Отправьте её через тестовый поток частями, затем сравните собранный текст с эталоном посимвольно. Повторите сценарий с обрывом и убедитесь, что результат не помечен завершённым и не сохранён как готовый. После этого проверьте ошибку и двойное событие завершения. Если все четыре сценария дают ожидаемые состояния, базовый потоковый клиент можно подключать к пользовательскому интерфейсу.