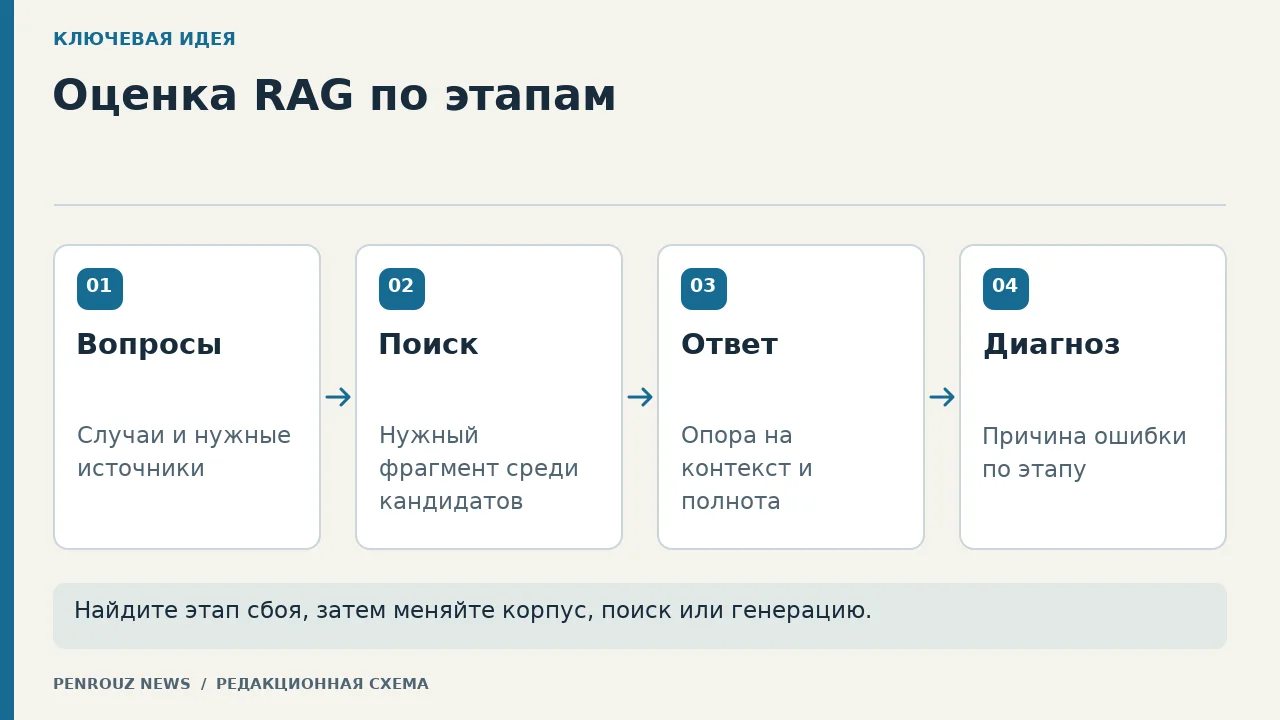
Короткий ответ: оценивайте поиск и ответ раздельно
Оценка RAG начинается не с одного общего балла, а с разложения конвейера. Сначала проверяют, оказался ли нужный фрагмент среди найденных кандидатов и соблюдены ли фильтры. Затем смотрят, использовал ли генератор этот контекст, ответил ли на вопрос и не добавил ли неподтверждённые утверждения. Если смешать два этапа, красивый ответ может скрыть плохой поиск, а слабая формулировка — обесценить правильно найденный источник.
Результатом проверки должна стать не абстрактная оценка «хорошо» или «плохо», а список проваленных случаев с установленным уровнем ошибки. Для каждого вопроса сохраняют ожидаемый документ, найденные идентификаторы, переданный модели контекст, итоговый ответ и решение по понятной рубрике. Такой журнал показывает, что менять первым: состав корпуса, разбиение и фильтры, ранжирование или правила генерации.
Контрольный случай связывает пользовательский вопрос с проверяемым основанием. Минимальная карточка содержит идентификатор, формулировку вопроса, допустимый документ или фрагмент, обязательные условия ответа и недопустимые выводы. Добавьте прямые вопросы, перефразировки, случаи с несколькими условиями и вопросы, на которые в корпусе ответа нет. Последняя группа особенно важна: она проверяет, умеет ли система честно сообщить о недостатке основания.
Набор не должен состоять из десятков почти одинаковых фраз. Полезнее покрыть разные причины сбоя: устаревшую редакцию, неверный раздел, пропущенное исключение, конфликт документов и пустую выдачу. Подробную структуру карточки и правила версионирования даёт руководство по контрольному набору для оценки ИИ.
Шаг 2. Проверьте retrieval до генерации
Для каждого случая сравните найденные кандидаты с заранее допустимыми основаниями. Простейший вопрос: присутствует ли нужный фрагмент в выдаче. Затем проверьте порядок, лишние кандидаты, версию документа, область доступа и сохранность соседних условий. Само наличие правильной записи ещё не гарантирует качества: если она находится в конце длинного списка, полезное основание может не попасть в контекст модели.
Сохраняйте идентификаторы, а не только текст. Устойчивый ID позволяет отличить две редакции похожего правила, открыть оригинал и повторить проверку после переиндексации. Устройство хранения и границы ответственности поиска подробнее разобраны в материале о векторной базе данных для RAG.
Шаг 3. Проверьте генерацию по переданному контексту
Когда retrieval проверен, оцените ответ отдельно. Разбейте его на существенные утверждения и для каждого найдите основание в переданных фрагментах. Отметьте полноту: сохранены ли исключения, условия, неизвестные сведения и части составного вопроса. Релевантный ответ говорит по задаче пользователя; обоснованный — не выходит за пределы контекста. Эти свойства связаны, но не заменяют друг друга.
Не требуйте дословного совпадения с эталоном, если смысл допускает несколько формулировок. Лучше фиксировать инварианты: нужное правило названо, исключение сохранено, источник указан, неизвестное не выдумано. Стиль и краткость можно оценивать отдельно, чтобы косметическая правка не маскировала фактическую ошибку.
Учебный пример: справочная служба мастерской
Представим вымышленную мастерскую с тремя документами: правила приёма техники, гарантийные условия и порядок выдачи. Контрольный вопрос: «Можно ли получить устройство другому человеку?» Эталонное основание — пункт выдачи, где требуется код заказа и доверенность. Проверка ниже не описывает запуск модели; это учебный пример того, как связать ожидаемый источник, найденные кандидаты и решение.
Раздельная проверка одного случая
Этап
Наблюдение
Решение
Корпус
Действующий пункт выдачи присутствует
Корпус пригоден
Поиск
Найден пункт выдачи и старое гарантийное правило
Нужный фрагмент есть, лишний кандидат отмечен
Контекст
Модели передан только пункт выдачи
Основание сфокусировано
Ответ
Названы код заказа и доверенность
Условия сохранены
Граница
Способ оформления доверенности не указан
Нужно сообщить «не указано»
Все документы и результаты вымышлены; таблица показывает метод проверки, а не испытание сервиса.
Шаблон карточки оценки RAG
{
  "case_id": "workshop-issue-01",
  "question": "Можно ли получить устройство другому человеку?",
  "expected_sources": ["ISSUE-04"],
  "must_have": ["код заказа", "доверенность"],
  "must_not": ["выдуманный способ оформления"],
  "retrieved_ids": ["ISSUE-04", "WARRANTY-OLD-02"],
  "context_ids": ["ISSUE-04"],
  "decision": {
    "retrieval": "pass_with_noise",
    "generation": "pass",
    "notes": "неизвестное обозначено явно"
  }
}
Шаг 4. Определите уровень ошибки
Если ожидаемого документа нет в корпусе, исправляйте данные, а не промпт. Если документ есть, но не находится, проверяйте границы фрагментов, представление запроса, фильтры и ранжирование. Если правильный кандидат найден, но не передан модели, ищите проблему в отборе контекста. Если контекст верный, а ответ добавляет лишнее или теряет условие, меняйте инструкцию генерации и рубрику приёмки.
Отдельная категория — неоднозначный контрольный случай. Если ожидаемый ответ нельзя вывести из доступных документов или два правила конфликтуют без установленного приоритета, тест не должен автоматически проваливать систему. Исправьте саму карточку, выпустите новую версию набора и повторите сравнение. Не переписывайте критерий задним числом только потому, что новая конфигурация дала неудобный результат.
Как сравнивать изменения
Сравнивайте варианты на одной неизменной версии набора и сохраняйте результаты по каждому case_id. Полезный отчёт показывает исправленные случаи, новые регрессии и неопределённые решения. Сводная доля прохождения удобна как указатель, но без списка ошибок она не объясняет причину. Не объединяйте retrieval и generation в одно число, если после него нельзя понять, какой компонент ухудшился.
Если поиск плохо справляется с точными кодами и смысловыми перефразировками одновременно, отдельным следующим экспериментом может стать гибридный поиск в RAG.
Типичные ошибки оценки
Оценивать только финальный текст и не сохранять найденные фрагменты.
Использовать те же вопросы для настройки и окончательной приёмки.
Считать высокий score кандидата доказательством истинности документа.
Смешивать устаревшие и действующие редакции без устойчивых ID.
Требовать дословного эталона там, где важны смысловые инварианты.
Менять сразу корпус, поиск и промпт, не зная причины улучшения.
Выдавать ответ автоматического оценщика за независимую истину без выборочной ручной проверки.
Границы и практический итог
Метрики и автоматические оценщики ускоряют сортировку большого числа случаев, но не отменяют проверку рубрики и спорных примеров человеком. Любой автоматический судья может ошибаться или предпочитать определённый стиль. Поэтому сохраняйте его обоснование, проверяйте выборку результатов вручную и оставляйте статус «нужна проверка», когда критерий не даёт уверенного решения.
Первичная работа RAGAS подчёркивает, что оценка RAG затрагивает несколько измерений: качество найденного контекста, его использование и релевантность ответа. Этот материал использует только устойчивую идею раздельной диагностики и не переносит точные результаты чужого эксперимента на конкретную систему.