Мультимодальная языковая модель: как она соединяет текст, изображение и звук
Мультимодальная языковая модель работает с несколькими типами данных в одной задаче. Разбираем, как связать текст, изображение и звук, сформулировать запрос и проверить, не добавила ли система отсутствующие детали.
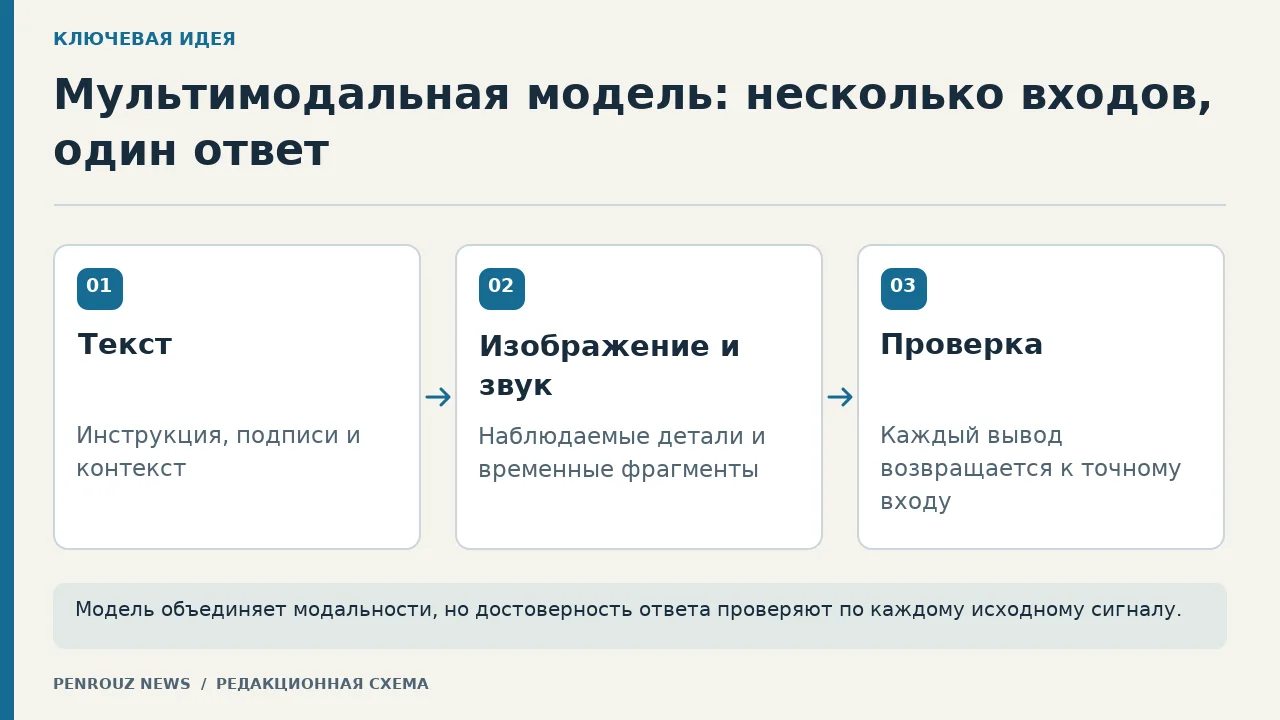
В этом материале8 разделовРедакционная схема PENROUZ NEWS. Модель объединяет модальности, но достоверность ответа проверяют по каждому исходному сигналу.PENROUZ NEWS
Короткий ответ: одна задача использует несколько типов данных
Мультимодальная языковая модель принимает не только текст, но и другие типы входа — например, изображение или звук — и связывает их в одном ответе. Пользователь может приложить фотографию и задать вопрос словами, передать запись вместе с инструкцией или попросить сопоставить подпись с видимой сценой. Главное слово здесь — «связывает»: модель должна учитывать отношения между разными частями задания, а не просто обработать каждый файл отдельно.
Такая система относится к более широкому классу «генеративный ИИ», но мультимодальность описывает не жанр результата, а способ работы со входом и выходом. Модель может получить несколько модальностей и вернуть только текст; это всё равно мультимодальная задача. И наоборот, создание картинки по короткой команде не объясняет, насколько система умеет сопоставлять детали изображения с длинным текстовым контекстом.
Что означает мультимодальность
В этой статье модальностью называется отдельный тип входного сигнала или представления: текст, изображение, аудио, видео либо структурированные данные. Это рабочее объяснение, а не утверждение об одной универсальной реализации. Например, ImageBind исследует общее пространство для шести модальностей, Flamingo — связь изображения или видео с языковой моделью, а технический отчёт Gemini описывает совместное обучение на изображениях, аудио, видео и тексте.
Мультимодальный ИИ не становится универсальным только потому, что принимает разные файлы. Для каждой задачи остаются отдельные критерии: видит ли система мелкий текст, различает ли похожие объекты, сохраняет ли порядок реплик, понимает ли, к какому кадру относится замечание. Поэтому сравнивать такие модели полезно не по обещанию «работает с фото и аудио», а по одному воспроизводимому сценарию и заранее записанным признакам правильного ответа.
Как несколько входов превращаются в один ответ
У мультимодальных моделей нет единственной обязательной архитектуры. В работе Flamingo визуальный энкодер преобразует изображение или видео в признаки, Perceiver Resampler — в фиксированный набор визуальных представлений, а языковая модель учитывает их через слои cross-attention при генерации текста. ImageBind показывает другой подход: совместное пространство представлений для изображения, текста, аудио и ещё нескольких типов данных. Поэтому безопасный общий вывод уже: разные входы преобразуются в машинные представления и связываются способом, заданным конкретной архитектурой. Базовый разбор объясняет, как работает большая языковая модель до добавления других модальностей.
Если материалов много, разделите их на именованные части: «фото А», «таблица Б», «фрагмент аудио В». После этого перечислите, что нужно извлечь из каждой части и какой общий вывод разрешён. Без такой схемы модель может объединить наблюдение с одной страницы и подпись с другой, хотя пользователь ожидал раздельный анализ. Хорошее задание показывает не только входы, но и допустимые связи между ними.
Чем мультимодальная модель отличается от обычной текстовой
Текстовая модель получает задачу через последовательность текстовых элементов. Мультимодальная добавляет представления других типов данных и позволяет ссылаться на них в той же задаче. Это удобно, когда перевод изображения в слова заранее потерял бы важные детали: расположение элементов, цветовую маркировку, паузы в речи или взаимное положение объектов. Однако текстовая часть по-прежнему задаёт цель, ограничения и формат ответа, поэтому расплывчатая инструкция остаётся расплывчатой независимо от числа вложений.
Не смешивайте мультимодальность с автономностью. Система может анализировать изображение и отвечать текстом, но не выполнять действия за пользователя. И наоборот, агент может пользоваться инструментами, оставаясь в основном текстовым. Эти свойства отвечают на разные вопросы: мультимодальность — какие данные участвуют в рассуждении, автономность — может ли процесс выбирать шаги и воздействовать на внешнюю среду.
Распознавание входа не гарантирует правильного понимания
Уверенное описание может содержать деталь, которой нет на исходнике, пропустить мелкую надпись или неверно связать подпись с объектом. Поэтому результат нужно раскладывать на проверяемые утверждения. Для изображения сначала фиксируют видимые объекты, текст и расположение, а уже затем делают вывод. Подробная схема есть в руководстве про описание изображения с помощью ИИ; она отделяет наблюдение от интерпретации и неопределённости.
Для аудио отдельно проверяют слова, говорящих, паузы и шумные участки. Для видео — кадры, порядок событий, речь и текст на экране. Если ответ соединяет несколько модальностей, каждому выводу нужен путь обратно к исходнику: какой кадр, какой временной фрагмент или какая строка подтверждает его. Формулировка «модель всё поняла» не является критерием; критерий должен позволять другому человеку повторить проверку.
Как составить мультимодальный запрос
Начните с результата: например, «составить карточку экспоната по фотографии и черновой заметке». Затем задайте роль каждому входу. Фотография подтверждает видимые признаки, заметка содержит авторские сведения, инструкция задаёт структуру. Укажите запрет на догадки: если дата или материал не видны и не названы, модель должна поставить метку «не указано». Завершите заданием формата — поля карточки и отдельный список утверждений, требующих проверки.
Если задача сложная, используйте два прохода. В первом модель перечисляет наблюдения по каждому входу без общего вывода. Пользователь исправляет ошибки и подтверждает факты. Во втором модель собирает текст только из принятого списка. Такой порядок уменьшает риск незаметно перенести неверное распознавание в гладкий итоговый абзац и позволяет понять, на каком этапе появилась ошибка.
Вымышленный пример: карточка музейного предмета
В учебном примере есть фотография вымышленной керамической чаши и заметка: «найдена в учебной экспедиции, точная датировка не установлена». Пользователь просит указать форму, видимый орнамент, состояние и сведения из заметки. Модель должна описать только различимые признаки, а в поле датировки написать «не установлена». Утверждение о регионе происхождения запрещено, потому что его нет ни на фотографии, ни в заметке.
Проверка проходит по полям. Орнамент и повреждения сверяют с фотографией; происхождение сведений — с заметкой; итоговый текст — со списком разрешённых фактов. Затем запрос повторяют с фотографией, где часть чаши закрыта. Хороший процесс не требует угадать скрытый участок: он ожидает явную отметку о невозможности наблюдения. Это проверяет не красоту формулировки, а дисциплину работы с границами входа.
Как проверить мультимодальный ответ
Сначала проверьте каждую модальность отдельно, затем связи между ними и только после этого общий вывод. Выпишите все конкретные утверждения, найдите подтверждающий фрагмент и пометьте статус: подтверждено, не видно, не слышно, противоречит или требует внешнего источника. Универсальный порядок помогает проверять ответы ИИ и не принимать связный рассказ за доказательство.
Практический чек-лист состоит из пяти вопросов. Понятно ли, какую роль играет каждый вход? Можно ли связать каждое утверждение с конкретным фрагментом? Отделены ли наблюдения от интерпретаций? Помечена ли неопределённость? Сохраняется ли результат при повторе на другом, заранее подготовленном примере? Если хотя бы один ответ отрицательный, сокращайте задачу, уточняйте формат или передавайте спорный фрагмент человеку.