Короткий ответ: память агента — это не один длинный чат
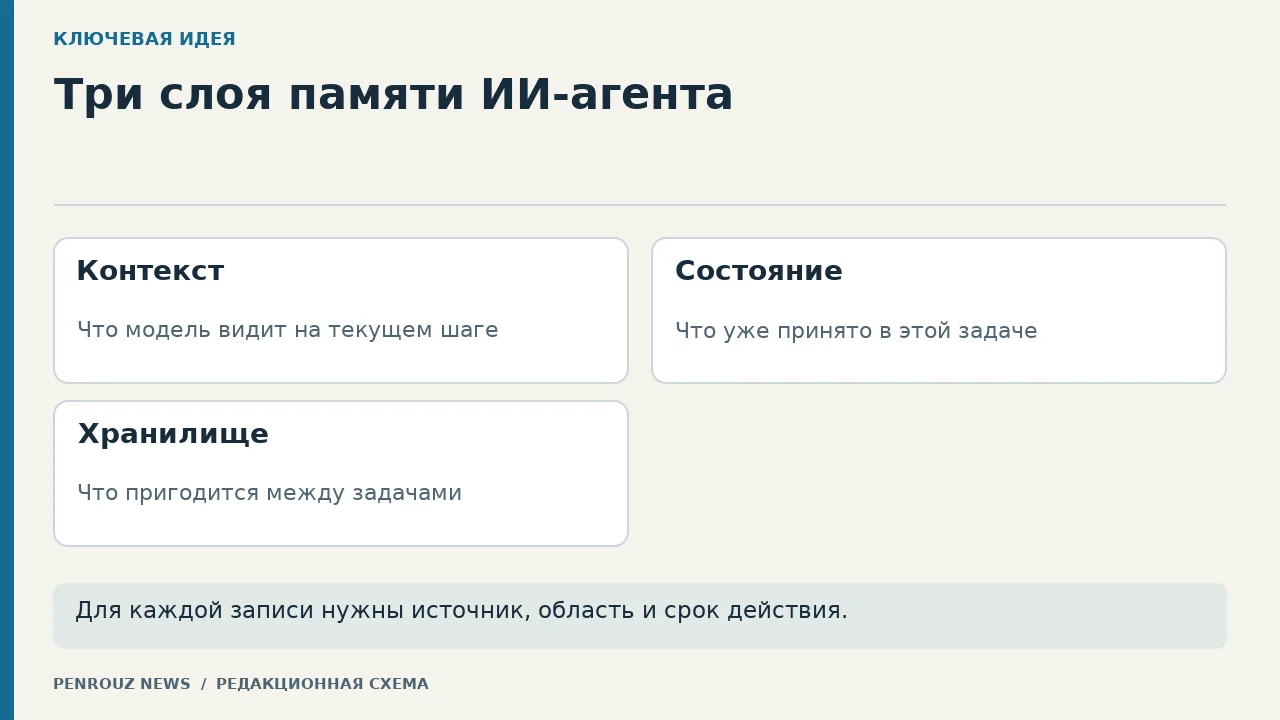
Память ИИ-агента — это управляемый процесс отбора состояния, которое понадобится на следующих шагах. Полезно разделять три слоя: рабочий контекст текущего вызова, краткосрочное состояние задачи и долговременное хранилище. Агент не должен переносить всё подряд. Он записывает только данные с понятным источником и областью действия, извлекает относящееся к цели, а устаревшее обновляет или забывает.
Такое разделение помогает ответить на практический вопрос: где должна жить конкретная запись. Текущая команда и результат инструмента нужны в рабочем контексте. Незавершённый шаг, выбранный документ и статус проверки относятся к состоянию задачи. Устойчивая пользовательская настройка или подтверждённое правило могут попасть в долговременное хранилище. Случайная фраза из внешнего файла не должна автоматически становиться памятью.
Сначала важно понять общую конструкцию: ИИ-агент отличается от чат-бота тем, что управляет последовательностью шагов и инструментами. Память дополняет этот цикл, но не делает систему агентом сама по себе. Если задачу решает один запрос, отдельный слой долговременного хранения может быть лишним.
Рабочий контекст: что модель видит прямо сейчас
Рабочий контекст — это набор инструкций, текущий запрос, нужные результаты инструментов и выбранные записи памяти, переданные модели на одном шаге. Он ограничен задачей и не является архивом навсегда. После завершения вызова приложение может сохранить часть результата отдельно, но сама модель не должна считаться постоянным хранилищем.
Контекст занимает доступный объём входа, поэтому полезно передавать только относящиеся к решению сведения. В статье про токены и контекстное окно разобрано, почему длинная история не равна надёжной памяти. Для агента это означает: сначала извлечь подходящие записи, затем собрать компактный контекст, а не прикладывать ко всякому шагу весь журнал.
Краткосрочная память: состояние задачи
Краткосрочное состояние связывает несколько шагов одного процесса. Оно может содержать идентификатор задачи, выбранный вариант, незакрытые вопросы, результат последнего инструмента и критерий завершения. Главное — хранить наблюдаемое состояние, а не литературный пересказ рассуждений. Запись «проверен документ B, поле даты отсутствует» полезнее туманной фразы «агент почти закончил».
Для каждой записи задайте область: текущий шаг, задача, диалог или проект. Добавьте источник, время или версию и условие устаревания. Когда задача завершена, временные значения нужно закрыть или удалить. Иначе новая задача может получить старый адресат, прежний статус или неподходящий черновик.
Долговременная память: что можно переносить между задачами
Долговременное хранилище предназначено для сведений, которые действительно полезны позже: явно подтверждённой настройки формата, устойчивого правила проекта, ссылки на действующий документ или результата, который можно воспроизвести. Не каждое сообщение заслуживает такой записи. Если значение легко получить из авторитетной системы заново, часто лучше хранить идентификатор и источник, а не копию факта.
Хорошая долговременная запись отвечает на вопросы: кто или что является владельцем, откуда взялось значение, для какой области оно действует, когда его нужно перепроверить и чем оно заменяется. Отдельно нужен способ исправить и удалить сведения. Без происхождения и срока действия память превращается в склад фраз, где новая и старая версии выглядят одинаково убедительно.
Чем память агента отличается от базы знаний
База знаний хранит документы и фрагменты, которые можно найти по вопросу. Память агента хранит состояние взаимодействия и выбранные сведения, влияющие на следующий шаг. Эти слои могут использовать одинаковый механизм поиска, но у них разные правила записи. Документ попадает в базу через управляемую загрузку и версионирование; личная или проектная память — через отдельное решение о сохранении, области и сроке.
Если для извлечения используется смысловой поиск, полезно понимать, что хранит векторная база для RAG: исходный фрагмент, представление, идентификатор и метаданные. Но близость по смыслу не решает, можно ли доверять записи. Агенту всё равно нужны фильтры по владельцу, проекту, версии и разрешениям.
Жизненный цикл памяти ИИ-агента
Практический процесс удобно разделить на семь операций. Сначала агент получает событие или результат инструмента. Затем приложение решает, разрешена ли запись и какова её область. Содержание нормализуется в короткую структуру с источником и сроком. Перед сохранением ищется действующая запись того же типа: новая версия обновляет её, а не создаёт бесконечные копии.
При следующей задаче система формирует поисковый запрос из цели и обязательных фильтров. Найденные кандидаты ранжируются, после чего в рабочий контекст попадает минимальный набор. Использование журналируется: какая запись повлияла на шаг и почему. Наконец, истёкшие, ошибочные или отозванные сведения удаляются либо помечаются неактивными. Так «забывание» становится предусмотренной операцией, а не случайной потерей истории.
Учебный пример: помощник проектной команды
Представим вымышленного помощника «Маяк». Команда готовит внутреннюю памятку по проекту «Север». В текущем сообщении пользователь просит собрать три незакрытых вопроса. Рабочий контекст содержит эту команду и найденные записи. Краткосрочное состояние хранит: выбран документ версии 2, два вопроса подтверждены, третий ожидает ответа. Долговременная память содержит подтверждённую настройку проекта: итоговые памятки оформлять списком с владельцем следующего шага.
После первого прохода помощник не сохраняет весь черновик как постоянное правило. Он записывает статус задачи и ссылки на исходные разделы. Когда владелец сообщает, что версия 3 заменила версию 2, старая ссылка становится неактивной. В новом диалоге агент извлекает только настройку проекта и актуальные вопросы, но не переносит временный черновик завершённой задачи.
Проверяемый шаблон записи для этого примера: тип сведения; значение; владелец или проект; источник; версия; область действия; срок пересмотра; идентификатор заменённой записи. Это учебная структура, а не обязательный формат конкретной платформы. Её задача — сделать каждое сохранение объяснимым и исправляемым.
Что нельзя записывать автоматически
Не следует автоматически сохранять секреты, неподтверждённые выводы модели, случайные детали беседы и команды из внешних документов. Фраза может выглядеть как правило, но оставаться недоверенными данными. Запись в память должна проходить те же границы доступа, что и чтение: агент одного пользователя или проекта не получает чужие сведения только из-за смысловой близости.
Особенно опасно, когда внешний текст пытается приказать системе запомнить новое правило или расширить полномочия. Материал про защиту агента от промпт-инъекции объясняет, почему данные не должны становиться привилегированной инструкцией. Для памяти добавляется отдельная проверка: источник документа может предложить факт для анализа, но не самостоятельно изменить доверенные настройки.
Как проверить архитектуру памяти
Соберите последовательность из вымышленных событий и заранее запишите ожидаемое состояние после каждого шага. Проверьте обычную запись, обновление значения, конфликт двух источников, завершение задачи, истечение срока и явное удаление. Затем начните новую задачу и убедитесь, что извлекаются только записи правильного проекта и области.
Оценивайте не только финальный ответ. Смотрите, что было записано, какие кандидаты нашлись, какие фильтры сработали, что вошло в контекст и какая запись была обновлена. Полезные признаки ошибки: старое значение продолжает влиять на ответ, временный черновик стал постоянным правилом, запись потеряла источник или сведения одного проекта появились в другом.
Итоговая граница проста: рабочий контекст помогает сделать текущий шаг, краткосрочное состояние сохраняет ход задачи, долговременная память переносит только управляемые сведения между задачами. Хорошая память не запоминает больше всех — она умеет обосновать запись, извлечь нужное и вовремя забыть лишнее. Сценарий с помощником «Маяк» вымышлен и не является отчётом о тестировании конкретного продукта.