Кэширование промптов: как ускорить повторные запросы и проверить cache hit
Кэш промпта может сократить повторную обработку длинного общего контекста, но срабатывает только при совпадающем префиксе и не гарантирует одинаковый ответ. Разбираем безопасную схему внедрения и проверяем её по метрикам API.
Короткий ответ: отделите стабильный префикс от меняющегося запроса
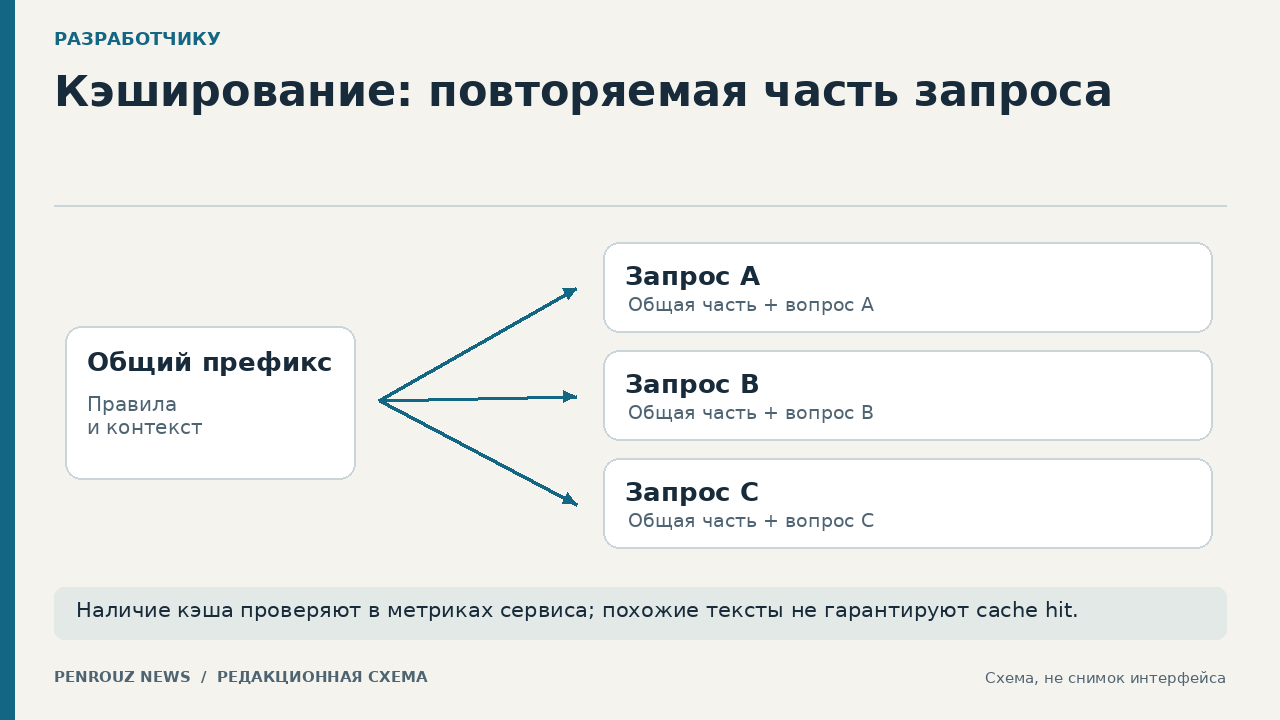
Кэширование промптов полезно, когда приложение много раз отправляет одной модели длинное одинаковое начало: системные правила, описание формата, определения инструментов, примеры или справочный документ. Поставщик может повторно использовать уже вычисленное состояние этого префикса, а обрабатывать заново только переменную часть. Чтобы получить пользу, поместите общий материал в начало запроса, сохраняйте его байт-в-байт или токен-в-токен неизменным и подтверждайте попадание по полям usage, а не по субъективному ощущению скорости.
Это не кэш готового ответа. Модель всё равно генерирует новый вывод после общего префикса, поэтому два одинаковых запроса могут дать разные формулировки. OpenAI прямо указывает, что prompt caching не меняет генерацию выходных токенов; Google и Anthropic также описывают повторное использование контекста, а не сохранённого результата. Если приложению нужен буквально тот же ответ на тот же ключ, это отдельный прикладной кэш поверх API.
Когда кэш действительно уместен
Хорошие кандидаты — длинная инструкция классификатора, постоянная база правил для помощника, один и тот же документ для серии вопросов или стабильный набор описаний инструментов. Общая часть должна быть достаточно большой для требований выбранной модели и повторяться в пределах срока жизни записи. Короткий промпт, который вызывается редко, может не пройти минимальный порог или не окупить запись. Пороги, срок хранения и тарифы различаются между моделями и меняются, поэтому их следует брать из актуальной документации конкретного API.
Сначала оцените объём общей части и меняющегося хвоста. Руководство про токены и контекстное окно помогает не путать длину текста в символах с числом токенов. В журнале эксперимента сохраняйте фактические значения usage: общий вход, кэшированные токены, токены записи кэша, время до первого фрагмента и полное время ответа. Только эти измерения показывают, произошла ли повторная обработка.
Как собрать запрос с устойчивым префиксом
Разместите в начале то, что меняется реже всего: системные ограничения, определения терминов, общую справку, примеры и схемы инструментов. После них добавляйте переменные данные конкретного запроса. Не вставляйте в начало текущее время, случайный идентификатор, имя пользователя или динамически переставленный список инструментов. Даже логически равные версии текста могут токенизироваться по-разному, если изменились пробелы, порядок блоков или сериализация JSON.
У разных API управление отличается. OpenAI описывает автоматические и, для поддерживаемых моделей, явные точки кэширования; Gemini предлагает неявное кэширование, а для части интерфейсов и моделей — явные объекты кэша; Claude поддерживает автоматический режим и явные breakpoints через cache_control. Поэтому не переносите параметр из примера одного поставщика в другой. Общий принцип переносим: стабильный префикс идёт первым, переменная часть — последней, а результат проверяется по телеметрии именно выбранного API.
Стабильность не означает, что инструкцию нельзя улучшать. Зафиксируйте версию префикса и меняйте её осознанно после теста. Материал о составлении промпта помогает отделить задачу, исходные данные и критерии готовности. После изменения инструкции ожидайте новый cache miss, затем повторите серию запросов и сравните качество ответа с предыдущей версией.
Рабочий пример: помощник для вымышленной службы поддержки
Представим вымышленный сервис «Маяк». Каждый запрос содержит постоянную инструкцию оператора, справочник категорий, политику эскалации и схему двух доступных инструментов. В конце добавляется новое обезличенное обращение. Соберите префикс один раз из версии правил `support-v1`, не включайте в него номер обращения и время, а переменную часть оформляйте отдельным последним сообщением. Модель должна вернуть категорию, краткое резюме и признак передачи человеку; никаких реальных персональных данных в тесте нет.
Подготовьте двенадцать вымышленных обращений: четыре типовых, четыре пограничных и четыре с недостаточными данными. Первый запрос прогревает или создаёт кэш и может быть дороже либо медленнее последующих. Затем отправьте остальные запросы с точно тем же префиксом. Для каждого сохраните идентификатор версии, модель, размер входа, число кэшированных токенов и задержку. Не приписывайте улучшение кэшу, пока API не сообщил cache hit в usage или эквивалентном поле.
Контрольный сбой полезнее идеального демонстрационного результата. В отдельной копии измените одну строку в начале справочника или порядок определений инструментов и повторите запрос. Ожидаемое наблюдение — уменьшение повторно использованной части или промах, поскольку изменился префикс. Затем верните исходную версию и проверьте восстановление попаданий, если запись ещё доступна. Такой тест показывает, какая граница действительно кэшируется, и помогает найти случайную динамику в шаблоне.
Что измерять кроме cache hit
Считайте не только долю попаданий. Сравните время до первого токена, полную задержку, обычные входные токены, токены чтения и записи кэша, а также итоговую стоимость по действующему тарифу модели. Отделяйте первый запрос от повторных: запись может иметь другую цену, чем чтение. Если общий префикс мал, запросы редки или постоянно меняются, суммарная стоимость может не улучшиться даже при технически рабочем механизме.
Кэширование не должно маскировать изменение поведения модели. Запускайте один и тот же контрольный набор и фиксируйте параметры генерации; руководство про temperature и top-p объясняет, почему вариативность нужно учитывать отдельно. Сравнивайте качество по заранее заданным критериям: правильность категории, сохранение ограничений, отсутствие выдуманных реквизитов и корректная эскалация. Быстрый ответ с нарушенными правилами не считается улучшением.
Почему кэш промахивается
Частые причины — другой model ID, изменённые системные инструкции, новый порядок инструментов, изменившаяся схема структурированного ответа, добавленный timestamp в начале или истёкший срок жизни. В многошаговом диалоге переписывание старой истории и компактизация также меняют префикс. Некоторые реализации зависят от маршрутизации и минимального размера, поэтому совпадающий текст не всегда гарантирует попадание. Диагностику начинайте со сравнения фактического сериализованного входа и полей usage.
Не пытайтесь искусственно дополнять короткий префикс бессмысленным текстом только ради порога. Дополнительные токены тоже обрабатываются и могут повысить стоимость или ухудшить инструкцию. Если общего полезного контекста мало, обычный запрос может быть проще. Если повторяется большой документ, проверьте, поддерживает ли выбранный интерфейс явный объект кэша и как считается его хранение.
Границы безопасности и конфиденциальности
Кэш не отменяет правила работы с данными. Передавайте только сведения, которые разрешено отправлять выбранному поставщику, и проверяйте политику хранения, регион обработки и совместимость с требованиями организации. Не считайте кэш анонимизацией: даже если поставщик хранит вычисленное состояние, исходный запрос всё равно обрабатывается сервисом. Секреты, персональные данные и закрытые документы требуют той же оценки доступа, что и обычный API-вызов.
Изоляция кэша и срок жизни зависят от платформы. Документация OpenAI описывает границы организации и региона, Claude — изоляцию по организации и workspace для своего API, а Gemini публикует собственные правила для неявного и явного кэширования. Эти сведения нельзя обобщать на все сервисы. Перед запуском зафиксируйте поставщика, модель, режим, TTL и допустимый класс данных.
Проверка результата
Внедрение готово к ограниченному использованию, если одинаковый полезный префикс подтверждён попаданиями по телеметрии, динамический хвост не разрушает кэш, контрольное изменение вызывает ожидаемый промах, а экономия рассчитана по реальным чтениям и записям. Дополнительно должен пройти тест качества на тех же примерах. Если метрики не показывают повторного использования, сначала исправьте структуру запроса; менять модель или увеличивать контекст стоит только после измеримой причины.