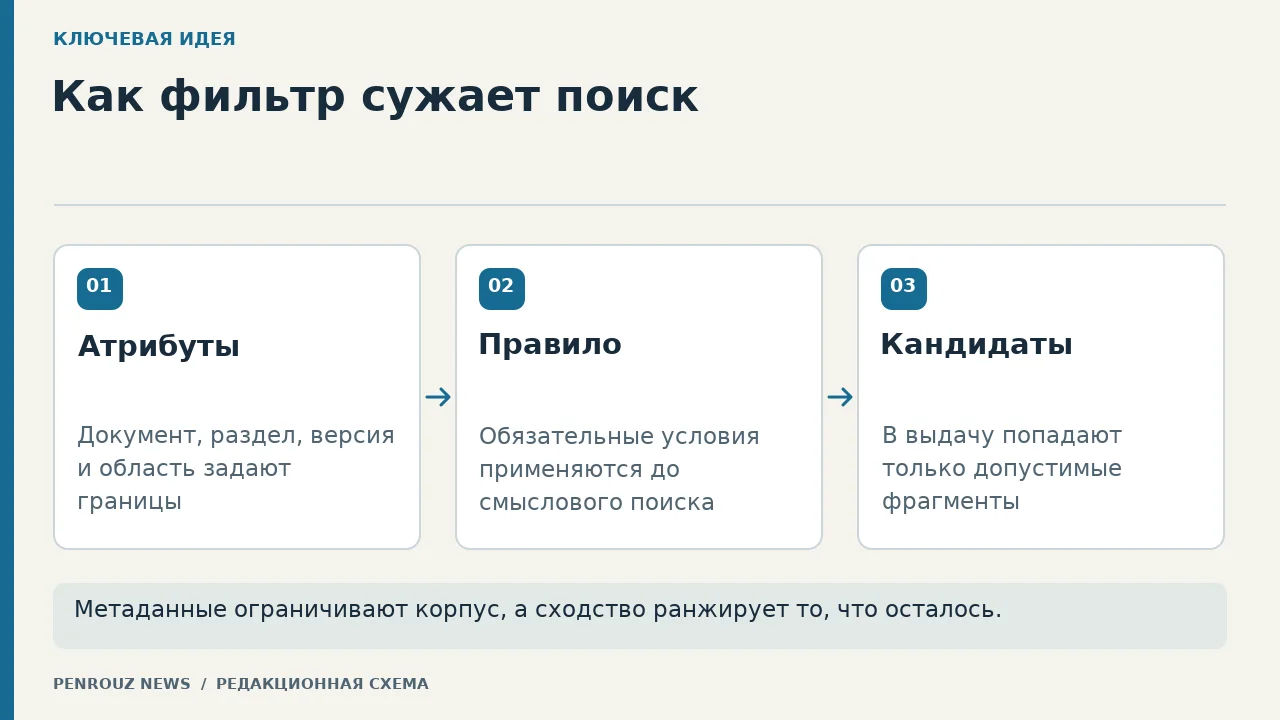
Фильтрация по метаданным в RAG — это отбор допустимых фрагментов по явным атрибутам до смыслового ранжирования или вместе с ним. Поисковая система получает вопрос пользователя, обязательные условия и корпус. Сначала она оставляет записи нужного документа, раздела, языка, версии или области, а затем сравнивает смысл запроса только с этим набором. Так близкий по формулировке, но неподходящий по происхождению фрагмент не вытесняет правильный.
Метаданные не отвечают на вопрос и не делают документ достоверным. Они дают управляемую границу: где искать, какие записи исключить и почему кандидат вообще попал в выдачу. Семантическая близость отвечает за порядок внутри допустимого набора, а фильтр — за принадлежность этому набору. Эти две операции нужно проверять отдельно.
Общий путь от документов до ответов описывает материал о том, как подготовить базу знаний для RAG. Здесь рассматривается более узкий этап: превращение атрибутов источника в проверяемое правило отбора.
Какие метаданные полезны для RAG
Полезное поле связано с решением, которое система должна принять при поиске. Идентификатор документа помогает собрать соседние фрагменты одного источника. Раздел отделяет правила оплаты от правил возврата. Статус версии исключает отменённую редакцию. Язык предотвращает случайное смешение переводов. Область или проект сужают поиск до нужного корпуса. У каждой записи должно быть понятное происхождение: атрибут лучше получать из управляемого каталога, а не угадывать по тексту.
Не стоит превращать в метаданные всё, что можно извлечь из документа. Поля должны быть стабильными, однозначными и пригодными для сравнения. Название темы, созданное моделью без проверки, может меняться и давать непредсказуемую выборку. Длинный пересказ в поле тоже не заменяет исходный фрагмент. Сохраняйте минимальный набор признаков, которые участвуют в фильтре, диагностике или восстановлении источника.
Поля и их роль в отборе
Поле
Пример значения
Какое решение поддерживает
Что проверить
document_id
handbook-returns
Связать фрагмент с документом
Идентификатор устойчив и не переиспользован
section
exceptions
Оставить нужный раздел
Список значений ограничен и согласован
revision_state
active
Исключить отменённые редакции
Статус обновляется при замене документа
audience_scope
support-team
Ограничить область поиска
Значение приходит из доверенного контура
source_url
путь к оригиналу
Открыть основание ответа
Ссылка ведёт к конкретному источнику
Учебная таблица показывает назначение полей, а не обязательную схему конкретной платформы.
Как составить правило фильтра
Начните не с синтаксиса базы, а с задачи читателя. Запишите, какие ограничения обязательны. Для вопроса о действующей политике возврата это могут быть тип документа «политика», статус «действует» и раздел «возврат». Затем разделите условия на обязательные и уточняющие. Обязательное условие не должно ослабляться ради большего числа результатов. Уточняющее можно использовать для ранжирования, если пустая выборка допустима и явно обработана.
Правило должно быть воспроизводимым. Система журналирует нормализованный запрос, переданные фильтры, число оставшихся кандидатов и причину пустого результата. Если фильтр собирается из пользовательского вопроса, сохраняйте исходную формулировку и распознанные значения отдельно. Это позволяет увидеть, ошибся ли поиск или ещё раньше неверно определена область.
Шаблон проверяемого поискового запроса
{
  "question": "Можно ли вернуть товар после вскрытия?",
  "required_filter": {
    "document_type": "policy",
    "section": "returns",
    "revision_state": "active"
  },
  "optional_hint": {
    "product_group": "device"
  },
  "return_fields": [
    "chunk_id",
    "document_id",
    "source_url",
    "revision_state"
  ]
}
Это вымышленный нейтральный пример структуры, а не запрос к определённому продукту. В нём видно, какие условия обязательны и какие данные нужны для проверки. Конкретный оператор и формат выражения зависят от хранилища, поэтому сначала полезно зафиксировать смысл правила, а уже затем переводить его в синтаксис системы.
Практический пример: три версии одной инструкции
Представим учебный корпус службы поддержки. В нём есть три фрагмента об обмене устройства: черновик, отменённая редакция и действующая инструкция. Тексты похожи, поэтому смысловой поиск без фильтра может поставить отменённую редакцию выше. Каждая запись получает document_id, section, revision_state, effective_scope и source_url. Вопрос пользователя относится к действующему правилу обмена.
Сначала система применяет условия section = exchange и revision_state = active. Черновик и отменённая редакция исчезают до ранжирования. Затем оставшийся набор упорядочивается по близости к вопросу. Если активного фрагмента нет, правильный результат — пустая выборка с объяснением, а не возвращение старого правила. Таким образом фильтр предотвращает подмену обязательного ограничения похожестью текста.
Чтобы воспроизвести проверку, подготовьте четыре контрольных вопроса: прямой вопрос об обмене, перефразировку, вопрос по соседнему разделу и вопрос без ответа. Для каждого заранее укажите ожидаемый document_id и допустимый revision_state. Сравните выдачу без фильтра, с обязательным фильтром и с заведомо слишком узким условием. Это не измеренный тест продукта, а шаблон проверки поведения.
Слишком широкий и слишком узкий фильтр
Слишком широкий фильтр оставляет неподходящие документы. Его признак — в выдаче встречаются верные по словам, но неверные по версии, разделу или области фрагменты. Исправление начинается с обязательных границ, а не с изменения промпта генерации. Слишком узкий фильтр, наоборот, удаляет правильный источник. Его признак — нужный документ существует, но число кандидатов падает до нуля после одного из условий.
Диагностируйте условия по одному. Сначала проверьте значения метаданных в записи, затем повторите запрос с базовым фильтром и по очереди добавляйте ограничения. Не ослабляйте правило молча. Если система делает fallback на более широкий корпус, это должно быть отдельным наблюдаемым решением с пометкой, что обязательное условие не выполнено.
Если поиск сочетает точные совпадения и смысловую близость, отдельный материал про гибридный поиск в RAG объясняет объединение каналов. Фильтр остаётся другой задачей: он определяет допустимость кандидата, а не способ вычислить его релевантность.
Где применять фильтр в поисковом конвейере
Предварительный фильтр сокращает набор до смыслового поиска и хорошо подходит для обязательных полей. Постфильтр проверяет уже найденных кандидатов и может быть удобен для вторичных правил, но он рискует оставить слишком мало результатов, если первоначальный поиск не получил достаточный запас. Комбинация возможна: жёсткие границы применяются до поиска, а дополнительные признаки — при окончательном отборе.
Векторное хранилище обычно связывает фрагмент, представление, идентификатор и атрибуты. Подробно о составе такой записи рассказывает материал о том, что хранит векторная база для RAG. Для текущей задачи важно другое: фильтр использует явные атрибуты, а не пытается восстановить статус версии из расстояния между векторами.
Как проверить фильтрацию по метаданным
Проверяйте retrieval отдельно от финального ответа модели. Для каждого контрольного вопроса сохраните ожидаемые допустимые документы, применённый фильтр и фактические кандидаты. Отдельно посмотрите ложные включения, когда прошёл запрещённый фрагмент, и ложные исключения, когда нужная запись отфильтрована. Пустой результат должен быть видимым и объяснимым.
Минимальная приёмка включает обычный запрос, перефразировку, конфликт версий, неизвестное значение поля и отсутствие ответа. После обновления документа повторите тот же набор, чтобы убедиться, что старая запись стала неактивной, а новая доступна. Не оценивайте фильтр только по красивому тексту: модель может сформулировать убедительный ответ даже тогда, когда поиск вернул неподходящее основание.
Для рабочей диагностики полезно связывать вопрос, нормализованные условия, кандидатов и выбранные фрагменты в одной трассе. Материал про наблюдаемость ИИ-агента показывает, как отделять событие, шаг и результат. Здесь такой журнал помогает точно назвать уровень ошибки: каталог метаданных, построение фильтра, поиск или генерация.
Чек-лист перед использованием
Перед передачей системы пользователям убедитесь, что значения полей берутся из доверенного процесса, список допустимых значений определён, замена версии обновляет статус старой записи, обязательные условия не ослабляются незаметно, а пустая выборка обрабатывается честно. Сохраните контрольные вопросы и ожидаемые документы. Любое изменение схемы метаданных запускает повторную проверку фильтров.
Итоговая граница проста: метаданные отвечают на вопрос «среди каких записей разрешено искать», а ранжирование — «какие из разрешённых записей ближе к вопросу». Когда эти роли разделены, ошибка становится проверяемой. Когда их смешивают, близкий текст может незаметно заменить действующее правило. Учебный корпус вымышлен: он показывает проверку фильтров, а не результаты испытаний конкретного продукта.