Короткий ответ: хороший фрагмент содержит законченный ответ
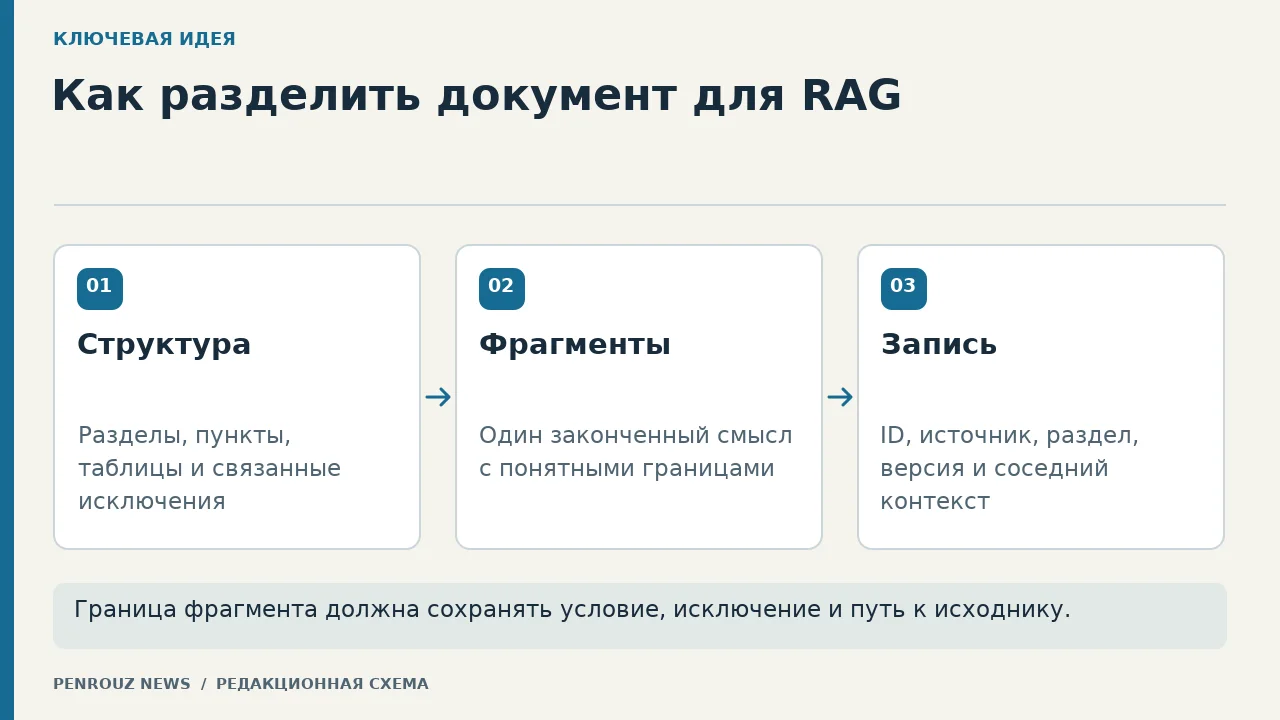
Чанкинг — это разбиение документа на фрагменты, которые система поиска сможет хранить, сопоставлять с вопросом и передавать языковой модели. Цель не в том, чтобы нарезать одинаковое число знаков. Каждый фрагмент должен сохранять один законченный смысл: правило вместе с условием, шаг вместе с предупреждением, строку таблицы вместе с названиями столбцов. Если граница проходит между правилом и исключением, поиск может вернуть правдоподобную, но неполную основу для ответа.
Результат чанкинга — не только текстовый отрывок. Полезная запись связывает сам текст с устойчивым идентификатором, документом-источником, заголовком раздела, версией и соседним контекстом. Благодаря этому найденный фрагмент можно показать человеку, обновить без смешения редакций и сопоставить с исходником. Embedding и векторный индекс работают уже с подготовленными записями; они не восстанавливают структуру, потерянную при разбиении.
Начните со структуры документа
Перед разбиением прочитайте документ как редактор. Отметьте заголовки, пункты, списки, подписи к таблицам, определения, примечания и перекрёстные ссылки. В регламенте естественная единица часто совпадает с пунктом и его подпунктами; в инструкции — с шагом, условием и предупреждением; в справочнике — с одной карточкой сущности. Формальная длина может использоваться как ограничитель, но не должна быть единственным правилом.
Общий маршрут подготовки корпуса — от выбора авторитетных документов до проверки ответов — описывает гайд о базе знаний для RAG. Чанкинг занимает в нём отдельный этап: он принимает уже выбранный и очищенный документ, а выдаёт набор записей для индексации.
Выбирайте границу по задаче поиска
Один и тот же документ можно разделить по-разному для разных вопросов. Если читатель спрашивает о порядке действий, полезно сохранять последовательность шагов. Если он ищет определение, отдельная запись может содержать термин, определение и область применения. Для таблицы нельзя оставлять значения без заголовков колонок. Для договора или политики исключение должно находиться рядом с основным условием либо быть явно связано с ним.
Слишком маленькие фрагменты хорошо совпадают с отдельными словами, но теряют контекст. Слишком крупные несут несколько тем сразу, из-за чего смысловой сигнал размывается, а в контекст модели попадает лишний текст. Поэтому начальная стратегия должна быть проверяемой гипотезой: выделите смысловые блоки, ограничьте чрезмерно длинные, а затем сравните варианты на одном наборе вопросов.
Перекрытие помогает только на реальных границах
Перекрытие означает, что соседние записи частично повторяют текст. Оно полезно, когда важная мысль действительно пересекает техническую границу: например, заголовок и вводное условие нужны обоим соседним пунктам. Но механическое повторение каждого фрагмента раздувает индекс и может вернуть несколько почти одинаковых кандидатов. Лучше сохранять небольшой необходимый контекст осмысленно: повторить заголовок раздела, добавить идентификатор родителя или связать соседние записи полями previous_id и next_id.
Сохраняйте идентификаторы и метаданные
У каждой записи должен быть устойчивый chunk_id, а также source_id документа и section_path — путь по заголовкам. Поля version и effective_status помогают не смешивать редакции. source_url ведёт к оригиналу, language описывает язык, а access_scope удерживает границы выдачи. Текст заголовка можно добавлять к содержимому для поиска, но одновременно стоит хранить его отдельно, чтобы интерфейс мог показать пользователю понятный источник.
После чанкинга эти записи поступают в векторную базу RAG, где текст, представление, идентификаторы и метаданные образуют одну управляемую запись.
Что сохранять в записи фрагмента
Поле
Зачем нужно
Проверка
chunk_id
Однозначно найти и обновить фрагмент
Не меняется при повторной индексации того же содержания
source_id
Связать фрагмент с документом
Открывается исходный документ
section_path
Восстановить заголовки и положение
Путь существует в исходной структуре
text
Передать законченный смысл
Условие и исключение не разорваны
version
Различать редакции
Действующая и архивная версии не смешиваются
previous_id / next_id
Вернуть соседний контекст
Ссылки ведут на реальные соседние записи
Минимальная карточка зависит от корпуса, но текст без источника и идентификатора плохо пригоден для диагностики.
Практический пример: регламент возврата
Возьмём вымышленный регламент магазина. В разделе «Возврат устройства» есть основное правило: заявление принимают после проверки комплектации. Следом расположен подпункт-исключение: для товара с активированной цифровой лицензией действует отдельный порядок. Ниже находится таблица с колонками «категория», «документ» и «действие». Нельзя превращать эти элементы в три независимых отрывка без связей: вопрос о лицензии может получить только общее правило.
Сначала создайте запись ret-3-main с заголовком раздела, основным правилом и ссылкой на исключение. Затем ret-3-license содержит подпункт, но также повторяет название раздела и связывается с ret-3-main через parent_id. Строки таблицы превращаются в отдельные записи только вместе с названиями колонок; source_id и version одинаковы для всех частей. Такая схема вымышлена и показывает форму результата, а не работу конкретного продукта.
Пример записи фрагмента
{
  "chunk_id": "ret-3-license",
  "source_id": "returns-policy",
  "section_path": ["Возврат", "Устройство", "Цифровая лицензия"],
  "text": "Для товара с активированной цифровой лицензией действует отдельный порядок проверки.",
  "parent_id": "ret-3-main",
  "previous_id": "ret-3-main",
  "next_id": "ret-3-table-category",
  "version": "действующая редакция",
  "source_url": "ссылка на исходный документ"
}
Проверьте фрагменты до индексации
Составьте контрольные вопросы, для которых заранее известны нужные записи. В нашем примере это прямой вопрос о возврате, перефразировка про активированную лицензию, запрос по строке таблицы и вопрос без ответа. Для каждого зафиксируйте ожидаемый chunk_id и обязательные условия. Затем вручную проверьте, что запись понятна без догадки, содержит путь к источнику и не скрывает соседнее исключение.
После индексации сравните несколько вариантов границ на одинаковом наборе запросов. Векторные представления помогают ранжировать смысловую близость, но качество embeddings нельзя путать с качеством разбиения.
Диагностируйте ошибку по найденным записям
Если нужный документ отсутствует среди кандидатов, сначала проверьте, была ли создана правильная запись. Если находится общий пункт, но теряется исключение, граница или связь между соседями выбрана плохо. Если возвращаются дубликаты, уменьшите бессмысленное перекрытие и введите устойчивое удаление повторов. Если точное обозначение не находится, не обязательно увеличивать фрагмент: возможно, нужен лексический поиск рядом со смысловым.
Когда смысловые и точные совпадения нужны одновременно, следующим этапом можно проверить гибридный поиск в RAG; он не заменяет чанкинг, а работает с уже подготовленными записями.
Критерий готовности
Чанкинг готов не тогда, когда получено много записей, а когда контрольные вопросы воспроизводимо находят законченные основания. Для каждой записи можно восстановить документ и место в нём; версии не смешиваются; исключения не теряются; таблицы сохраняют заголовки; дубли не заполняют выдачу. После изменения правил разбиения повторите тот же тест и сравните конкретные промахи. Вымышленный регламент иллюстрирует выбор границ фрагмента, а не результаты испытаний конкретного сервиса.